

我終於進入真正的Codex自動化工作流
前面幾篇Codex 筆記,我一直都還在學一些比較基礎的東西。
什麼是智能體?CLI是什麼?API是什麼?怎麼把自己原本的工作方法封裝成 Skill?
到了這個章節,我開始覺得難度突然往上跳了一個層級。
因為這一次不再只是讓 Codex 產生文字,而是要真的讓它去串接外部工具,一路完成:劇本 → 圖片 → 影片 → 剪輯。
也就是說,之前學到的技能、API、CLI、規劃、反饋,在這一章終於全部開始接起來了。
老師這次用「歷史人物影片」當示範。理想狀態是我只需要給 Codex 一個人物名字,例如李白、李清照、諸葛亮,後面的工作全部交給智能體完成。
-
- 先寫人物的一生。
- 再根據每一段人生經歷產生畫面。
- 把圖片變成一段一段影片。
- 最後再把影片放進剪輯草稿。
- 當整套流程測試成功之後,再把它封裝成技能。
以後不管換成哪一個人物,都不用再重新教一次。
這堂課真正要學的,不是「歷史人物影片」
我覺得這一點一定要先弄清楚。
老師雖然拿歷史人物影片示範,但這不是這堂課真正的重點。
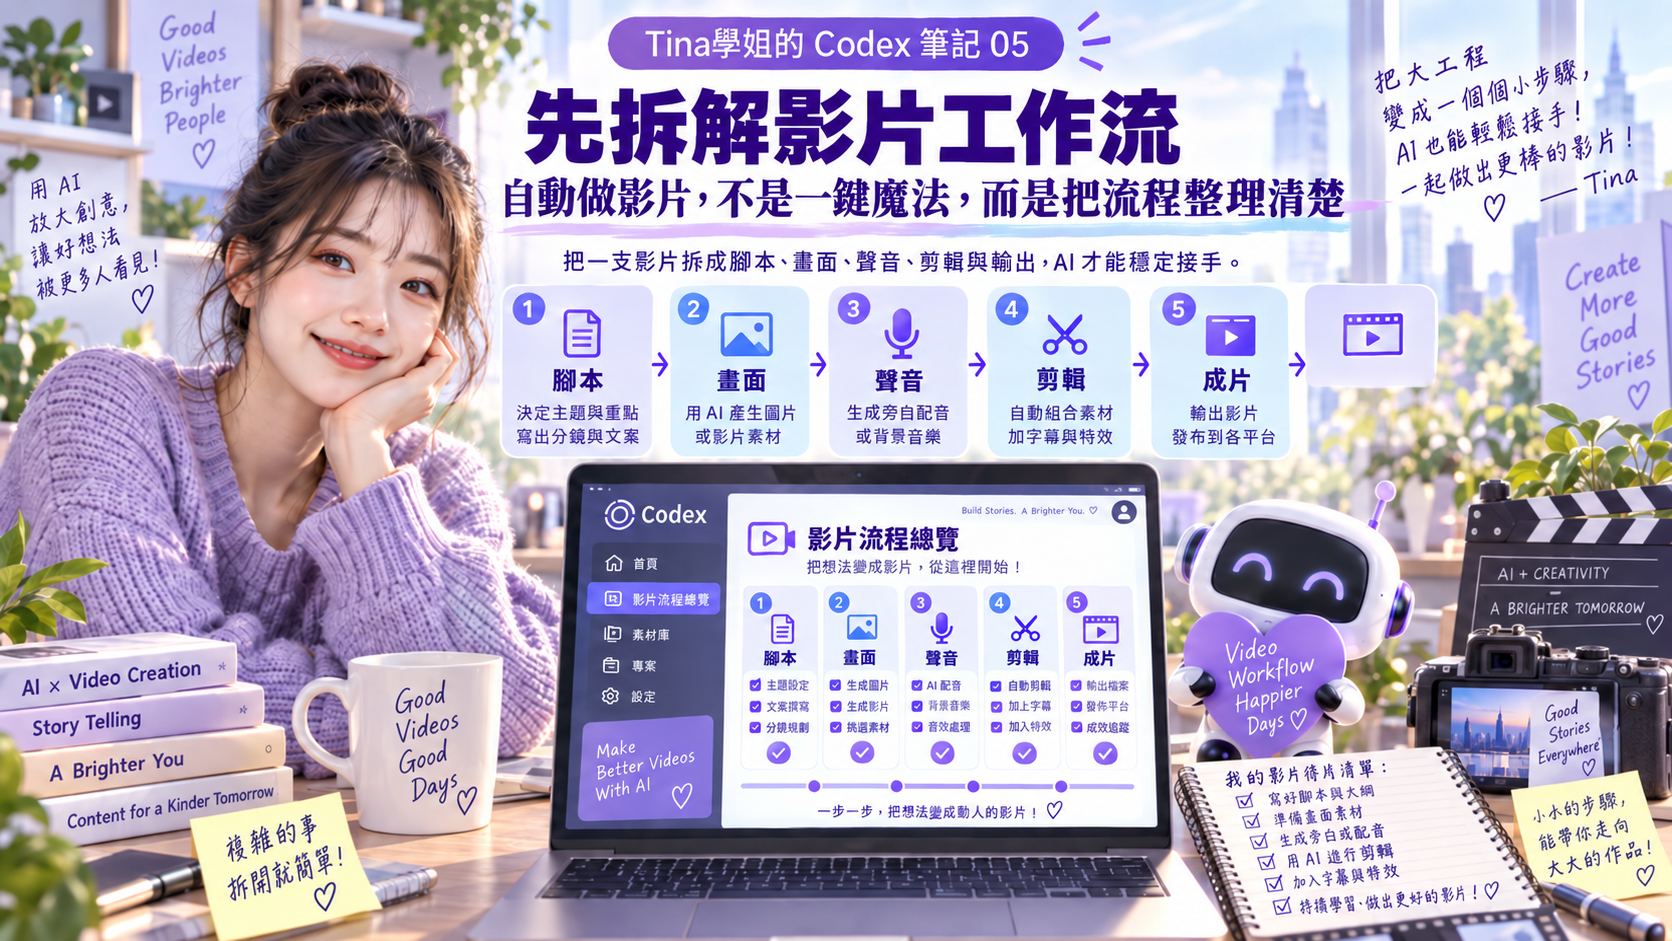
真正值得學的是:如何把一件原本需要操作很多軟體的工作,拆成標準流程,再讓Codex按照順序自動執行。
老師設計的影片工作流,大致可以分成四個階段。
-
- 第一階段,生成劇本。
- 第二階段,生成圖片。
- 第三階段,把圖片轉成影片。
- 第四階段,進入剪輯。
這跟我平常做 AI 短影音其實非常像。
我現在自己做影片,也是先想內容、產生素材,再進剪映或其他剪輯工具完成。
最大的差別只是:現在我要試著把原本由我操作的每一個步驟,慢慢交給Codex。
第一步:先把「劇本」變成標準化輸出
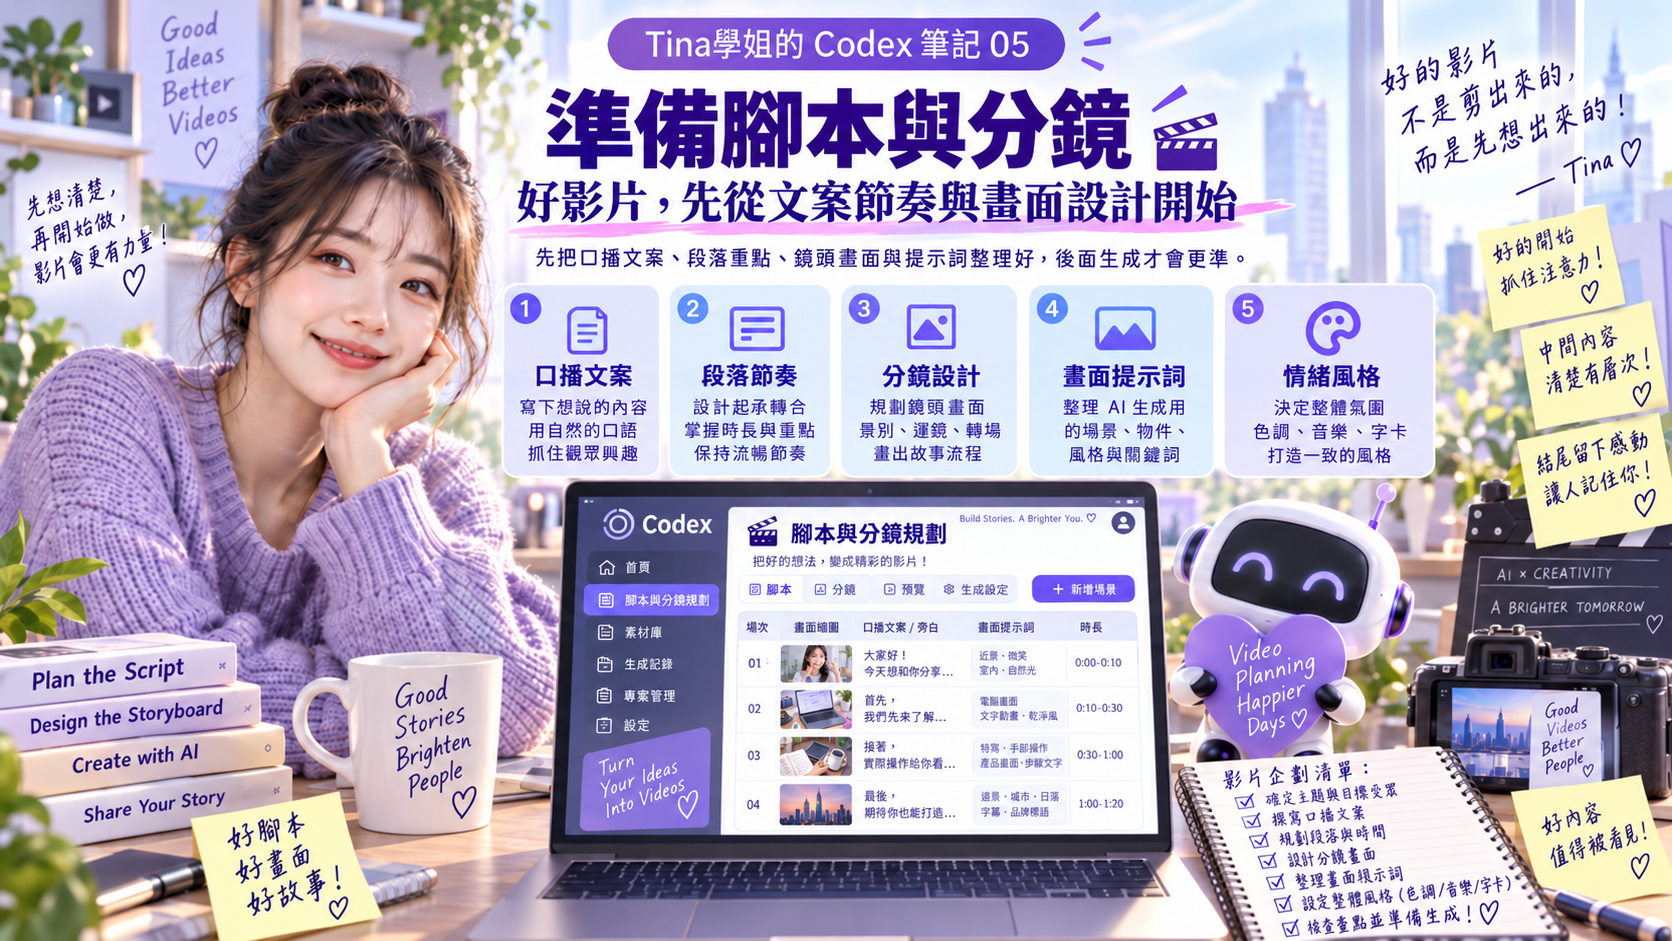
自動化影片的第一步,仍然不是圖片,也不是影片。而是文字。
因為後面所有視覺素材,都必須建立在一套清楚的劇本架構上。
老師這次延續上一篇建立 Skill 的方法,先讓 Codex 根據一個人物名稱,產生幾個固定內容。
-
- 第一是影片標題。
- 第二是人物的重要生平經歷,也就是後面影片會使用的字幕或旁白內容。
- 第三則是每一段字幕所對應的「畫面描述」。
這個畫面描述非常重要。
因為後面 AI 做圖時,不能只拿一句很簡單的字幕就要求它產出理想畫面。
-
- 畫面裡的人物幾歲?
- 穿什麼?
- 場景在哪裡?
- 正在做什麼?
- 環境、氣氛、構圖大概是什麼?
- 描述得愈完整,後面做圖時就愈有依據。
練習時,不需要一開始就做8段
這裡有一個我覺得非常實際的觀念。
老師原本的案例是把人物的一生拆成多段,例如8段,再生成對應的8張圖。
但是他特別提醒:如果現在只是學習流程,不需要一開始就做那麼多。
可以先改成3段或4段。
原因非常簡單。
後面的圖片與影片都需要消耗模型額度與費用。
我們現在的目標不是拍出一支可以拿奧斯卡的影片。
第一階段真正的目標,是先把整條流程跑通。
這一點我很認同。
因為如果連第一個 API 都還沒接成功,就一次生成8張圖、7段影片,只是在增加除錯成本。
第二步:Codex本身不會所有事情,所以要替它接上「做圖能力」
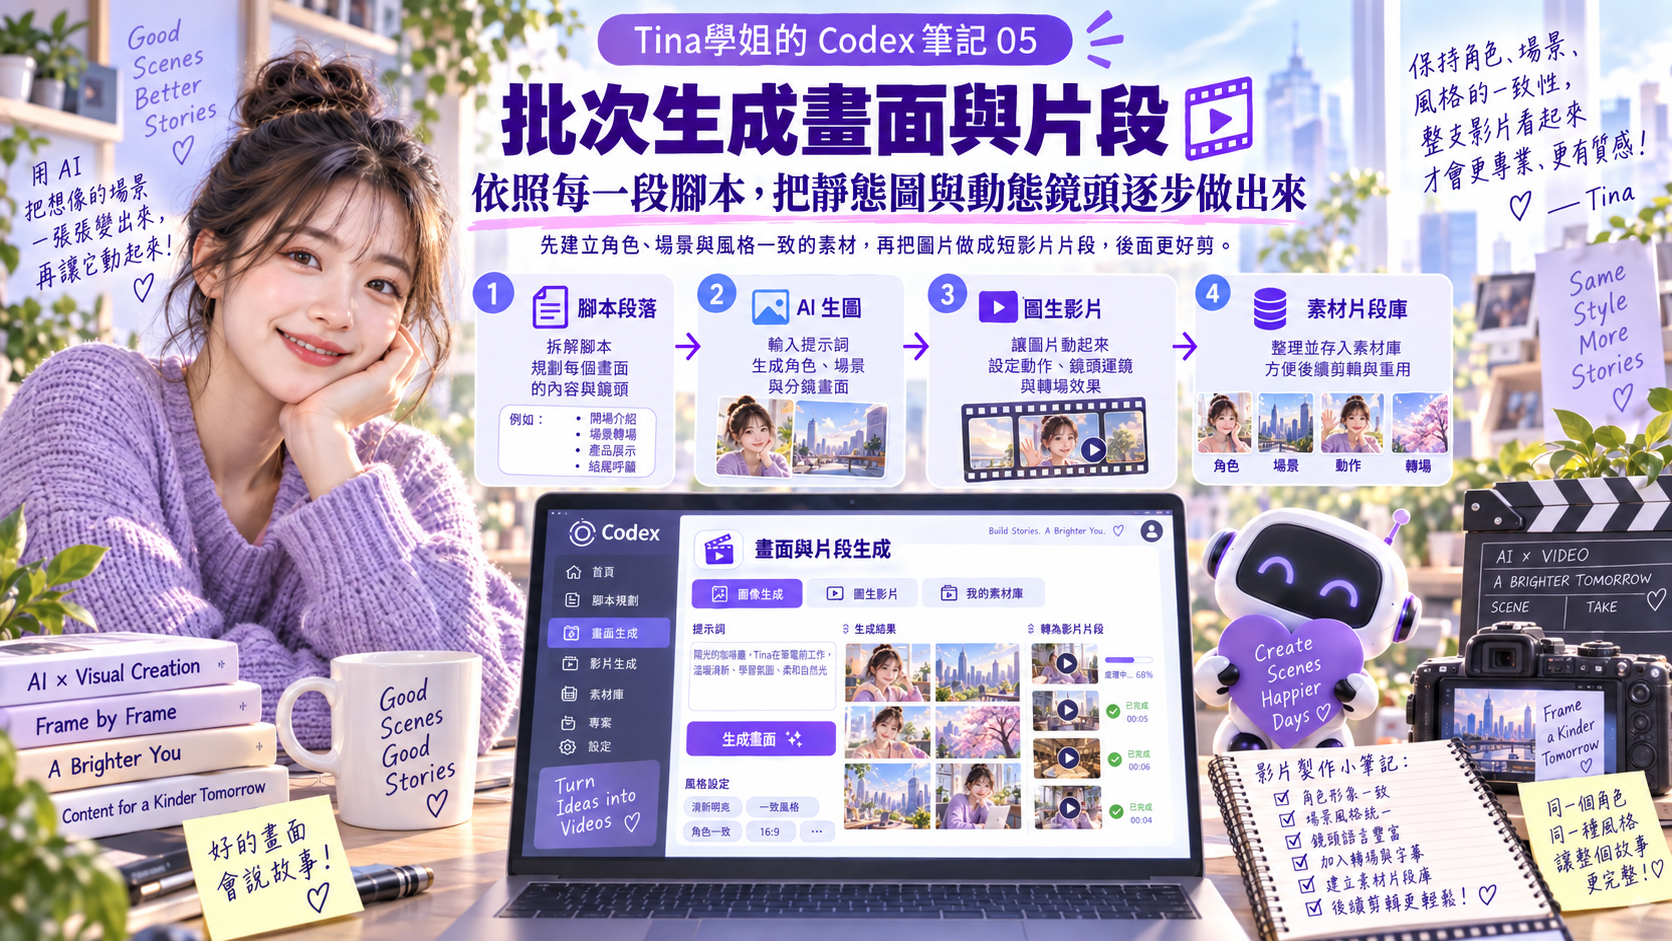
劇本完成之後,接下來就開始進入 API。
這也是我看到第三章後,覺得難度明顯提高的地方。
老師的概念其實很簡單:Codex本身負責規劃與執行,但如果需要某種它沒有的能力,就透過API接上外部服務。
例如今天需要生成圖片。
我們可以找一個有圖片生成 API 的服務,再把使用方法交給 Codex。
課程示範主要使用火山引擎裡面的模型服務。
但老師也一直強調,工具並不是固定的。
市面上只要有提供相關能力與 API 的服務,理論上都可以依需求替換。
API Key我現在會把它理解成「Codex使用我帳號的鑰匙」
這一堂又再次碰到 API Key。
老師用了很白話的方式解釋。
平常我們自己登入一個 AI 平台,可能使用帳號、手機驗證或其他方式。
但是今天不是「我」登入。
是 Codex 要從程式裡呼叫這項服務。
所以服務必須知道:這個請求是誰發的?使用哪一個帳戶?費用應該算在哪一個帳戶?API Key就是其中很重要的一項驗證資訊。
因此老師也特別提醒:API Key不要隨便給別人。
因為它可能代表別人可以使用你的服務額度,甚至產生費用。
我覺得未來真正開始做 Tina 版工作流時,這個觀念一定要特別注意。
最有意思的一步:不要自己研究API文件,讓Codex讀
以前我看到 API 文件,通常第一個反應就是:「這不是工程師看的東西嗎?」
裡面一堆 Endpoint、Request、Parameter、JSON,看幾行就想關掉。
但這堂課的做法完全不同。
老師的核心想法是:我不需要先把整份API文件研究懂,真正需要讀懂文件的人是Codex。
我們可以把相關 API 文件、使用說明或參考資料交給它。
讓 Codex 自己了解:
-
- API地址在哪裡?
- 需要哪些參數?
- 模型名稱是什麼?
- 怎麼送出生成圖片的請求?
- 結果怎麼拿回來?
- 然後請它建立對應的腳本。
這時候我突然理解上一篇為什麼要學 Scripts 和 References。
References就是讓智能體學習某個服務怎麼使用。
Scripts則把真正的 API 呼叫變成可以重複執行的工具。
先生成一張圖片測試,不要直接批量跑
我覺得這一章另一個很值得學的觀念,就是:先測一個,再做一批。
例如設定好圖片 API 之後,不是馬上叫 Codex 生8張。
-
- 先拿一段畫面描述測試。
- 確認 API Key 正常。
- 確認模型能用。
- 確認參數沒有錯。
- 確認圖片能成功下載到本機。
- 這些全部通過之後,才進入批量生成。
這其實就跟我們測試任何工作流程一樣。
一個步驟都還沒成功,就不要急著把規模放大。
為什麼圖片要「並行生成」?這是我這堂課第一次真正理解並行
當單張圖片測試成功後,老師開始要求 Codex 一次產生多張圖片。
這裡出現一個重要概念:並行。
假設一張圖片生成需要40秒。
如果按照順序:第一張完成,再做第二張,再做第三張……8張圖可能就要等很久。
但如果 API 允許同時送出多個請求,就可以一次把8個圖片任務送出去。
伺服器同時處理。
最後再把8張結果一起拿回來。
這也是自動化真正開始產生效率差異的地方。
以前我只是覺得「AI比較快」。
現在開始理解:真正的效率提升,不只來自模型生成速度,還來自工作流程如何設計。
AI生成失敗不一定代表流程壞掉,智能體還可以自己重試
課程實際測試圖片時,也碰到了提示詞審核沒有通過的情況。
這反而是一個很好的實戰案例。
其中一張圖片失敗後,Codex並沒有讓整個工作流直接停止。
它先保留已經成功的圖片,再判斷失敗原因,修改有問題的提示內容,重新送出該張圖片。
這正好呼應第三篇學到的「反饋與優化」。
智能體真正有價值的地方,不只是執行。
而是:執行 → 發現問題 → 修改 → 再執行。
這一段讓我第一次看到,前面學的理論真的跑進工作流程裡了。
第三步:圖片完成後,再開始做「首尾幀影片」
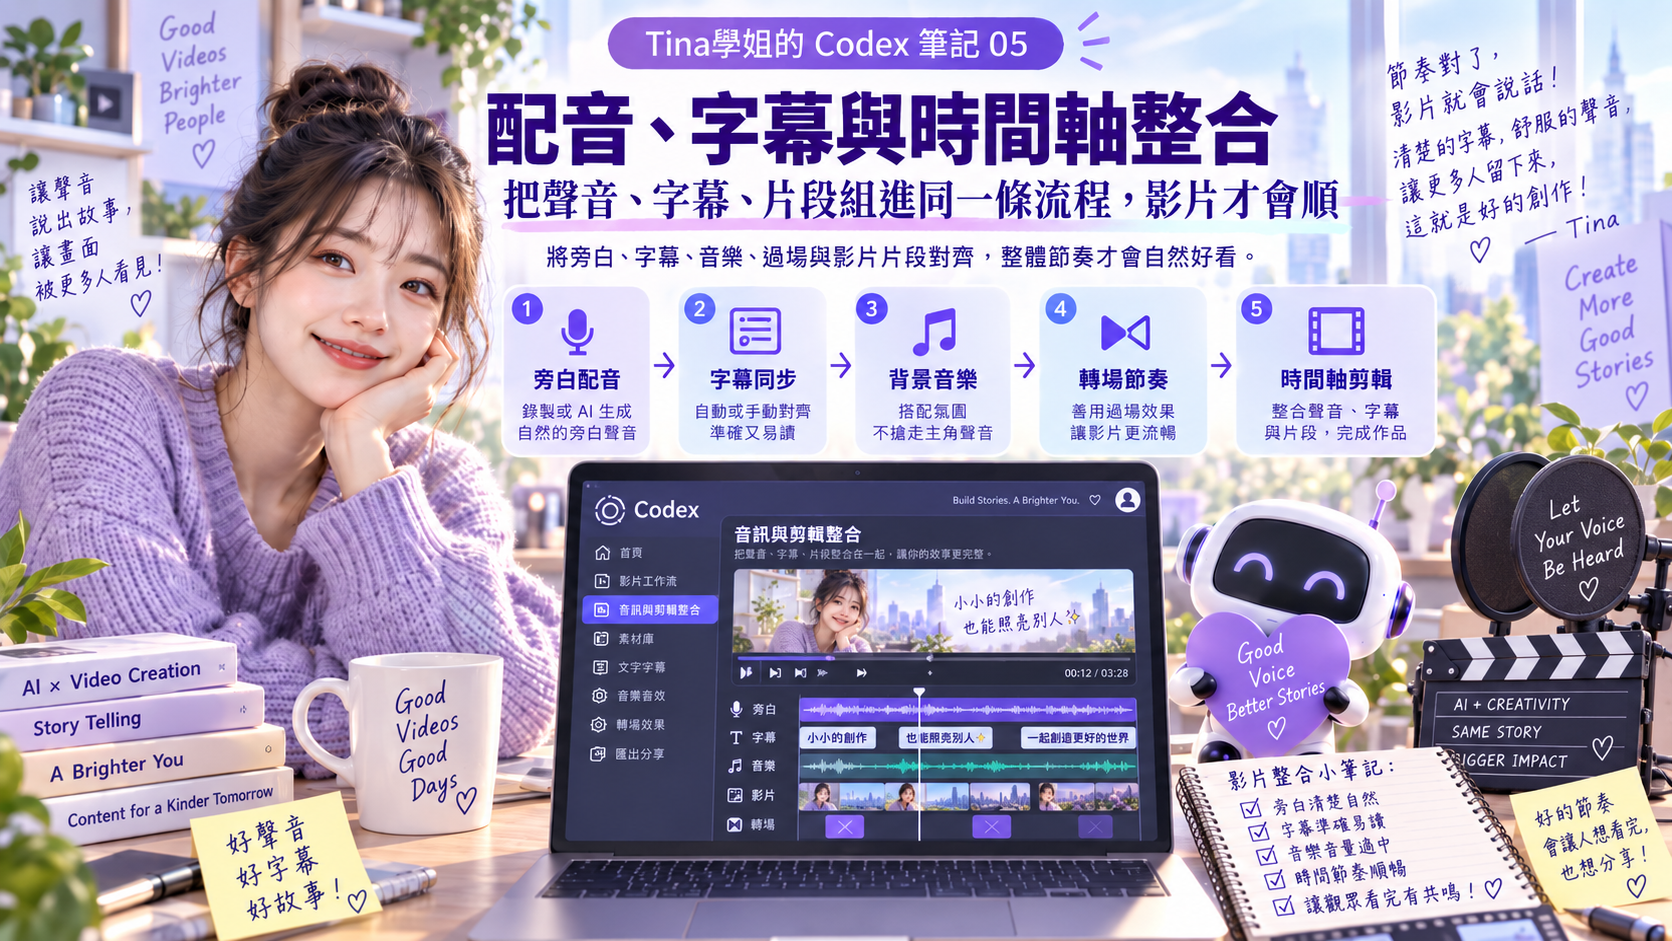
圖片全部準備完成,接下來就進入影片。
老師這次採用的是「首尾幀」的方式。
例如現在有8張圖。
第1張當第一支影片的首幀,第2張當尾幀。
接著第2張變成下一支影片的首幀,第3張當尾幀。
如此一路往下。
因此8張圖片,最後可以形成7段過渡影片。
這樣做有一個很重要的好處:每一段影片彼此比較容易連起來。
不是每5秒突然跳到完全不同的畫面,而是讓 AI 去演繹:「這一個畫面,如何慢慢變成下一個畫面。」
對歷史人物的一生來說,就可能從孩童慢慢走向成年,再進入人生下一個階段。
影片API比圖片API多了一個重要概念:「非同步任務」
做到影片時,我又學到一個新的 API 概念。
做圖片有時很快。
但影片通常沒有辦法你送出一個請求,馬上就得到成品。
因此流程比較像:
-
- 第一步,送出影片生成請求。
- 第二步,伺服器回傳一個任務ID。
- 第三步,Codex隔一段時間去查:「做好了嗎?」
- 如果還沒完成,就再等一下。
完成之後,再取得結果。
我現在會把它理解成:送件 → 拿號碼牌 → 查進度 → 領結果。
這其實就是很多耗時 API 任務常見的工作模式。
影片連結一定要保存,這是實戰中才會發現的小細節
課堂測試時,老師中途才想到一件事情:影片生成成功後,除了下載影片,還要把每一段影片的網址保存下來。
為什麼?
因為後面的剪輯流程可能還需要這些連結。
如果沒有保存,做完影片之後又得重新找一次,甚至重新產生。
我覺得這件事情很值得記下來。
因為真正做自動化時,我們不能只想「這一步能不能成功」。
還要想:這一步的結果,下一步需要什麼?
這也是工作流程和單純使用AI最大的差別。
這一章我開始看懂:真正重要的是「中間結果」
以前人工操作時,中間結果比較容易被忽略。
反正圖片就在畫面上,影片生成之後我自己下載。
但自動化不同。
每一步都應該留下可以被下一步使用的資料。
例如:
-
- 劇本輸出畫面描述。
- 畫面描述交給生圖 API。
- 圖片檔案交給影片 API。
- 影片 API 回傳任務ID與影片連結。
- 影片素材再交給剪輯流程。
所以真正的自動化不是很多 AI 工具排在一起。
而是上一個步驟的輸出,可以正確變成下一個步驟的輸入。
我覺得這句話,是這一章非常重要的觀念。
Tina學姐的學習心得:我開始覺得「工具不是重點,接口才是重點」
這一章老師用了火山引擎、即夢等平台示範。
坦白說,看到這裡,我第一個想法就是:這些工具不一定會是我最後真正使用的工具。
尤其我平常工作的環境、付款方式與常用軟體,和大陸使用者並不完全相同。
所以我不想變成:老師用哪個平台,我就永遠綁死哪個平台。
但是我覺得這堂課仍然非常值得學。
因為真正重要的並不是「火山引擎要按哪一個按鈕」。
真正要理解的是:一個外部AI服務,要怎麼變成Codex可以使用的工具。
只要我理解這件事,未來換圖片平台、換影片模型,甚至改用其他國際服務,整個工作邏輯仍然是類似的。
所以我現在的策略會是:先把老師的架構學懂;等到自己實作時,再建立Tina版的工具組合。
Tina學姐的Codex筆記05|我的結論
第幾個章節學完,我終於第一次看到一條真正的 AI 自動化影片生產線開始成形。
輸入一個主題或人物。
Codex先產生標題、字幕與畫面描述。
接著讀取圖片 API 的使用方法,自動產生圖片。
多張圖片可以利用並行任務提升效率。
圖片完成後,再透過影片 API 建立首尾幀影片。
如果影片生成需要時間,就利用任務ID反覆查詢狀態。
完成之後,把影片與連結保存下來,準備交給下一個剪輯流程。
我現在開始真正理解:Codex真正厲害的,不是它自己會做所有事情。而是它可以學會怎麼使用不同工具,再把很多工具串成一條完整的工作流程。
而這也讓我更確定,接下來我真正要做的,不是完全照老師的平台複製。
而是先把這條邏輯學會,再逐漸建立一套真正適合我自己的 Tina AI 影片工作流。