

前面學 Codex 的時候,我一直在理解一件事:Skill 到底和一般 Prompt 有什麼不同?如果只是每次把一大串指令貼給 AI,告訴它要生圖、做影片、轉檔,那其實還不能算真正的自動化。
所以這次我決定不再只看教學,而是真的從零開始,做一個屬於自己的短影音 Skill。我把它命名為 Tina Short Video Skill,目標很單純:讓我未來只要告訴 Codex「今天要做什麼主題」,剩下的圖片生成、影片生成、轉檔與批次管理,都由 Skill 自己處理。
這次實作過程比想像中長,也踩了不少坑,但也正因為真的踩過,我才開始理解:真正有價值的 AI 自動化,並不是「一小時生成幾百支影片」,而是知道哪些事情應該交給 AI、哪些根本不值得花 AI 的錢。
第一步:先把 AI 影片環境真正跑通
我的工作環境是 Windows,專案統一建立在:C:\Tina_AI_Video
這次實際安裝與測試的核心工具包括 Python、FFmpeg、Google GenAI SDK,以及 Gemini API。Python 負責執行各種自動化腳本,Gemini 負責生成首圖與連續動作圖,Veo 負責把首尾幀轉成影片,而 FFmpeg 則負責最後的本機轉檔。
這裡我第一次很明顯感受到「本機工具」的重要性。像影片從 8 秒轉成 5 秒這種事情,其實完全沒有必要再丟給任何付費 AI,只要交給 FFmpeg 就能處理,而且速度快、沒有 API 成本。
實測成功的第一條工作流
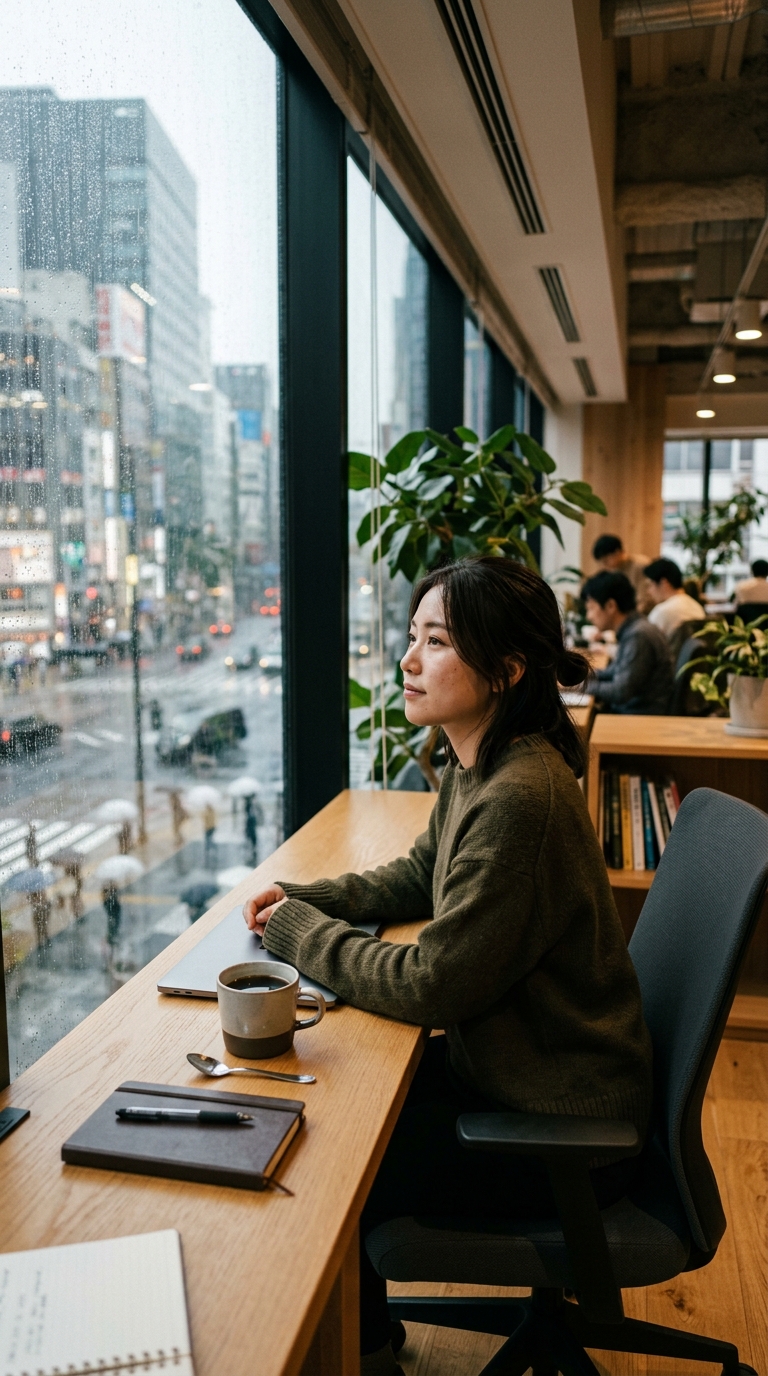
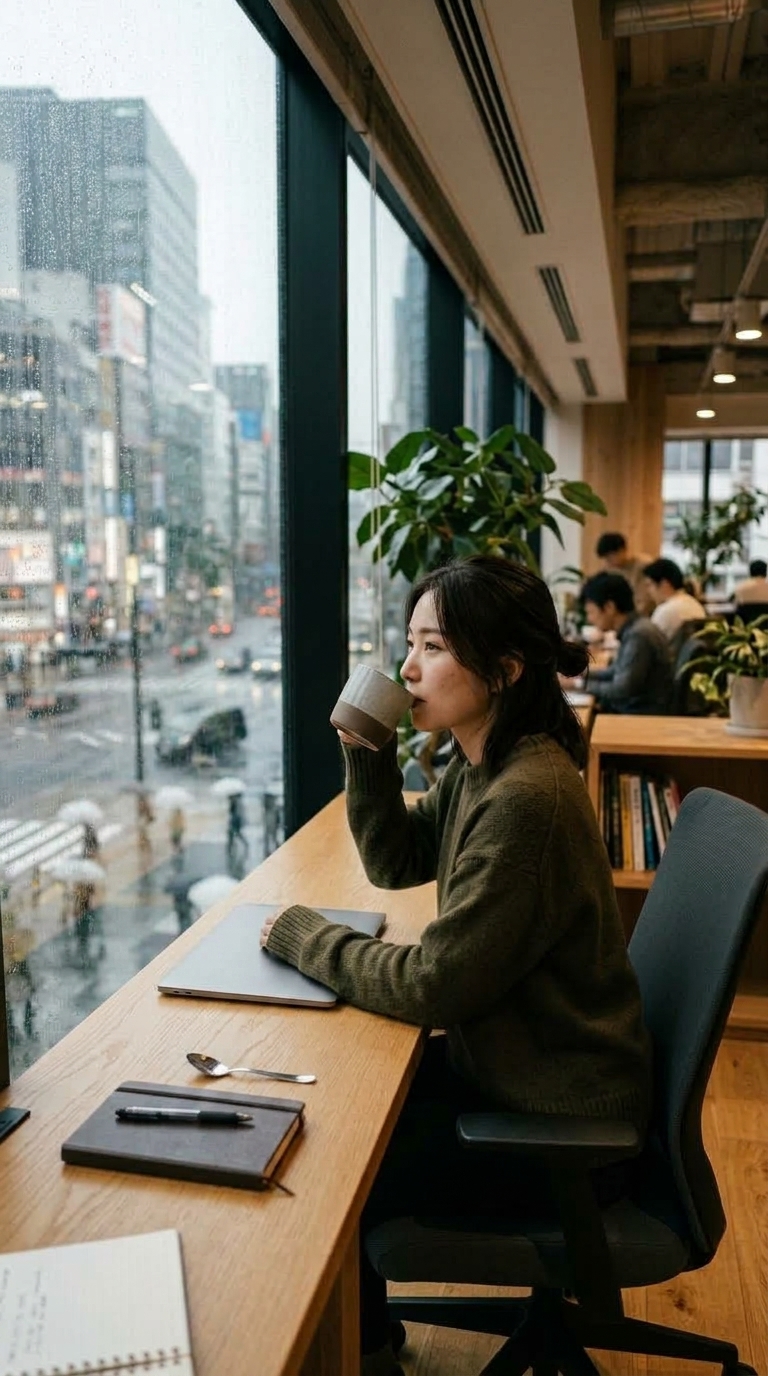
最早跑通的流程是:第一張情境圖 → 第二張連續動作圖 → Veo 生成 8 秒影片 → FFmpeg 轉為約 5 秒影片
例如第一張圖是人物坐在雨天窗邊,看著窗外;第二張圖則讓同一個人物拿起桌上的咖啡杯。只要人物、服裝、場景與構圖夠一致,Veo 就能利用首尾幀把中間動作補出來。
這一步成功之後,我才正式確定:這套流程是可以被封裝成 Skill 的。
第二步:把流程封裝成 Tina Short Video Skill
一開始我把 Skill 建在自己的專案資料夾中,後來才進一步讓 Codex 正式辨識。Codex 專案級 Skill 最後放在:
C:\Tina_AI_Video\.agents\skills\tina-short-video-v1
裡面包含主要的 SKILL.md、規則文件與實際可執行 scripts。
最初收進去的核心程式有:
-
generate_first_image.pygenerate_second_image.pygenerate_first_video.pymake_5sec_video.py
另外還保留過兩個商品相關實驗程式:
-
place_real_product.pygenerate_holding_product.py
真正讓我覺得「Skill 做成功了」的那一刻,不是檔案放進資料夾,而是 Codex 能夠讀到 Skill、正確列出 scripts,並且真的依照 Skill 去執行 Python、Gemini、Veo 與 FFmpeg。
從那一刻開始,它才不再只是一些散落的 Python 程式,而是一個 Codex 可以理解與使用的工作流程。
第三步:商品置入,成為這次最大的教訓
因為我的其中一個實際品牌是慢慢烘咖啡,所以我當然會想:既然人物與場景都能 AI 生成,那是不是也可以順便把真正的慢慢烘掛耳包放進去?
結果這裡反而成為整次實驗最有價值的一段。
第一次:讓 AI 直接生成商品
效果不好。掛耳包容易被做得太大,像咖啡豆袋,甚至變成小立牌。品牌文字、插畫與包裝細節也可能被重新畫過。
對品牌來說,這是不能接受的。AI 畫得再漂亮,只要 Logo、文字或商品比例錯了,就失去商業使用價值。
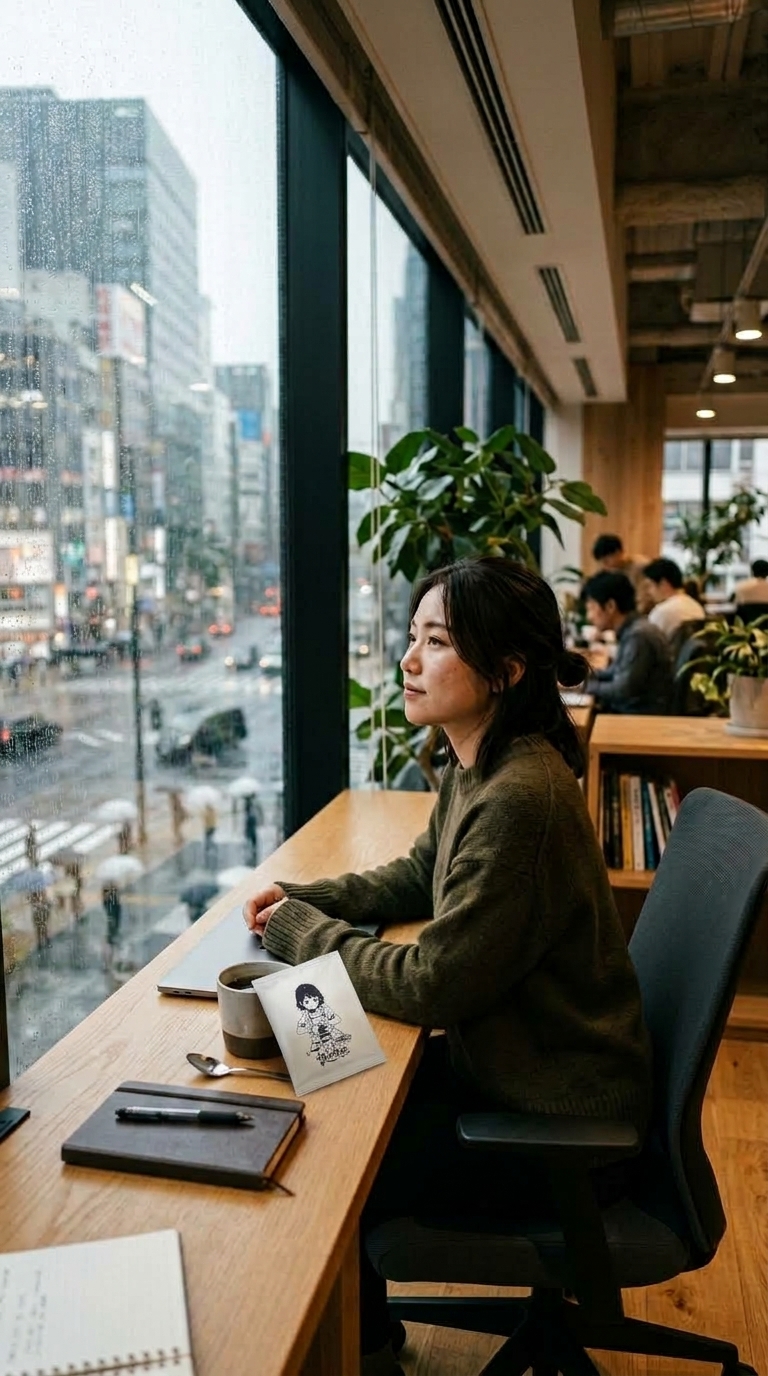
第二次:讓人物拿著掛耳包
這次我使用真實商品 Reference,人物手拿商品的效果乍看還可以,但正式批次測試時,竟然出現了「三隻手」。哈哈~
這也讓我重新思考:一般人喝掛耳咖啡,本來就不會特地坐在那裡拿著包裝給鏡頭看。為了商品露出而強迫人物拿商品,反而會讓畫面變得像硬廣告。
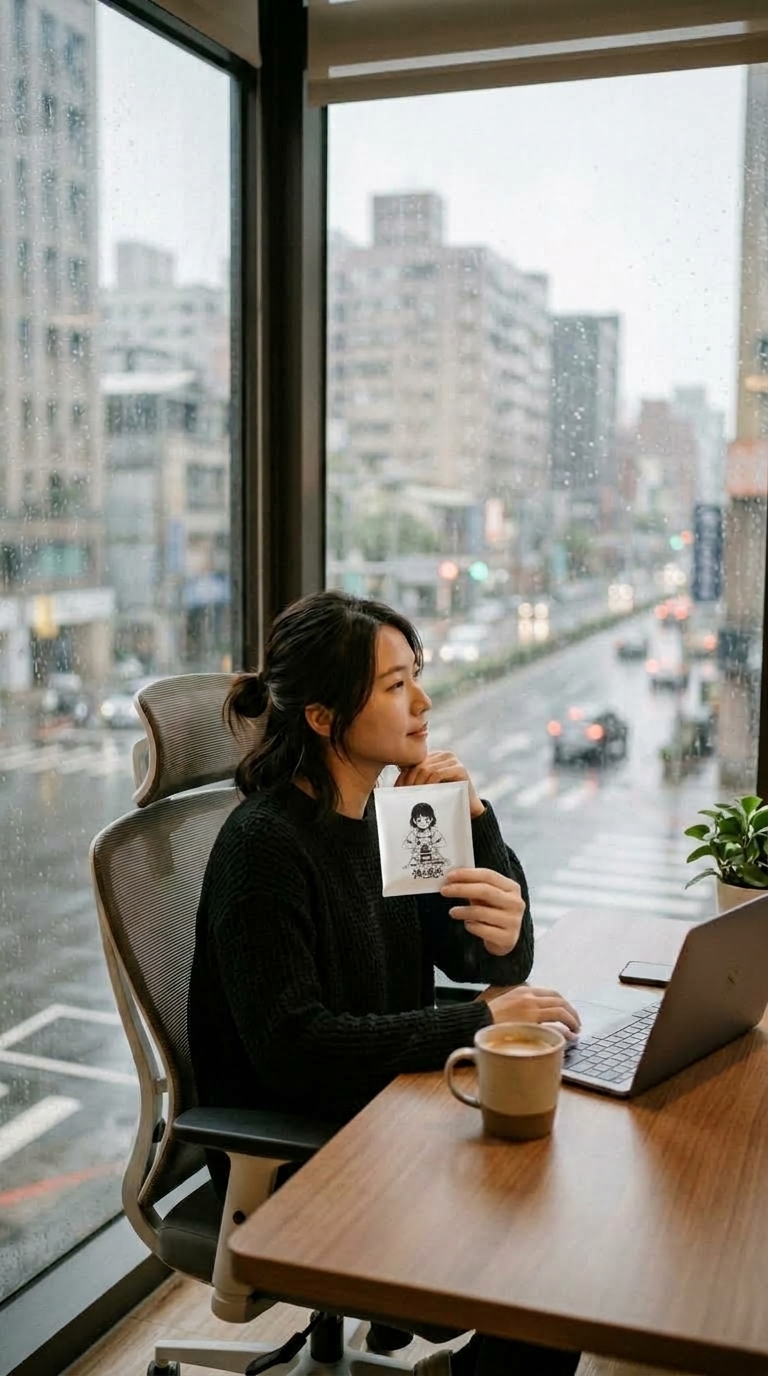
第三次:把真實 PNG 貼到桌面
我又試著使用真實透明 PNG,把掛耳包後製到咖啡杯旁邊。接著甚至再做透視、旋轉與陰影,希望它看起來像真的躺在桌面上。
結果還是很明顯像「貼上去的」。
原因很簡單:真實包裝躺在桌面時會有皺摺、反光、厚度、接觸陰影與現場光線,單純把一張平面的透明 PNG 做旋轉與陰影,很難真正騙過人的眼睛。
這一連串失敗最後反而得到一個非常重要的結論:AI 負責情境,真實素材負責品牌。
慢慢烘之後的正式策略,不再要求 AI 畫面一定出現商品。AI 可以負責人物、情緒、雨天、辦公室、閱讀、深夜工作等情境;真正的掛耳包、撕包、掛杯、沖泡與商品特寫,交給手機實拍。
第四步:從「一支一支做」升級成批次生產
Skill 單支能跑通之後,我馬上產生另一個疑問:YouTube 上很多人都說可以一小時生成幾十支、甚至上百支影片,那難道我要一支一支在 Codex 輸入指令嗎?
答案當然是不需要。
真正的批次工作流,應該讓 Codex 一次規劃很多支內容,再由我挑選值得執行的部分。
因此我建立了:C:\Tina_AI_Video\queue\content_queue.csv
這份 CSV 就像影片生產工作單,記錄影片編號、主題、情境、首尾幀、動作、是否核准、執行狀態、輸出路徑與錯誤訊息。
實測第一批時,我一次規劃 5 支影片,再只核准其中 3 支。之後只下一個批次指令,Codex 就自己依序完成首圖、尾圖、Veo 8 秒影片與 FFmpeg 5 秒影片。
這次三支真的批次生成成功,也證明「不用一支一支敲 Prompt」這件事是做得到的。
第五步:技術成功,不代表值得生成
不過真正讓我改變方向的,是看完那三支批次影片之後。
影片技術上沒有問題,人物也自然,畫面也漂亮。但是人物只是拉窗簾、整理文件、寫字,旁邊剛好放著咖啡。
我突然發現:這種畫面 Canva 裡不是一大把嗎?
如果只是普通辦公室 B-roll、閱讀、打字、拉窗簾、通勤或咖啡館生活,我為什麼要花 Gemini 和 Veo 的費用去重新生成?
這裡讓 v1.1 產生了最重要的一次升級。
第六步:加入 Canva、真人、AI 三種素材分流
從這裡開始,我不再把 Skill 定義成「AI影片產生器」,而是希望它變成一個「素材製作主管」。
每一支題材都先判斷:
| 素材類型 | 適合內容 |
|---|---|
| Canva / Stock | 一般生活 B-roll、辦公、閱讀、通勤、普通喝咖啡 |
| 真人實拍 | 品牌商品、包裝、撕包、掛杯、沖泡、Logo與細節 |
| AI | 素材庫難找的特殊情緒、劇情、人物連續動作與客製場景 |
同時又加入一個很實用的判斷:coffee_role = background / action / story
如果咖啡只是放在桌上,就是 background;如果人物真的拿起、喝下或放下咖啡,就是 action;如果咖啡參與整個故事情緒與轉折,才是 story。
我很喜歡的一個判斷:咖啡移除測試
我後來替 Skill 加了一個非常簡單的問題:「如果把咖啡杯拿掉,這支影片還完全成立嗎?」
如果答案是「是」,那咖啡其實只是背景,通常根本不值得用 Veo。
如果拿掉咖啡之後,故事的情緒或意義就變弱,才可能值得進入 AI 候選。
第七步:AI 候選還要再篩一次
即使第一輪被標成 AI,我也不希望它立刻花錢生成。
所以 v1.1 又加入第二次審核:素材庫真的難找嗎?咖啡是不是故事不可缺少的一部分?5 秒內能不能看懂?有沒有複雜手部或商品操作?AI 相較 Canva 是否真的有明顯價值?
最後只有 AI 價值達 4 分以上,而且成功率不是低,才允許真正進 Gemini+Veo。
這個機制實測後非常有意思。
一次規劃 10 支題材,第一輪分成 Canva、真人與 AI;原本只有 3 支進入 AI 候選,再經過第二次審核,最後只有 1 支真正值得生成。
這讓我第一次真正理解:大量生產的重點不是「大量 AI 生成」,而是「大量規劃,再少量精準生成」。
第八步:真正值得 AI 的畫面,差別在哪裡?
其中一支我很喜歡的測試題材是:「金繼杯重新盛滿的那一刻」
場景是一個陶藝工作室,雨後的窗邊,人物拿著修復過的金繼杯,再重新盛滿咖啡。
這種畫面就比較難直接從 Canva 找到,因為它需要特定的金繼杯、陶藝空間、雨後氣氛與「修復之後重新開始」的象徵。
另一支我認為 AI 很有價值的,是夜班之後坐在昏暗樓梯間,人物疲憊地拿起咖啡喝一口。這裡咖啡不是桌上的道具,而是故事情緒的落點。
這兩支讓我更確定:AI 真正值得用的地方,是「素材庫很難剛好找到我要的故事」。
第九步:批次工作一定要有斷點續跑
實測批次的時候,我還遇到一個非常實際的問題:Codex 使用額度突然到上限。
當時其中一支影片已經做完首圖、尾圖與 8 秒 Veo,只差 FFmpeg 轉成 5 秒;另一支則還在處理中。
如果批次系統沒有斷點續跑,重新開始就可能把 Gemini 與 Veo 全部再跑一次,等於再付一次錢。
所以我又替 Skill 加上 Resume 規則:檔案存在就跳過,完成過的步驟不重做,只補缺少的部分。
例如 8 秒影片已經存在,就絕對不能重新呼叫 Veo;只差 5 秒影片,就只跑 FFmpeg。
後來實測 Resume 成功,兩支中斷的影片都順利續跑完成,而且 Codex 明確回報沒有重新呼叫 Gemini 或 Veo。
我認為這一點對未來一次跑 10 支、20 支甚至 30 支,比「批次生成」本身更重要。
最後,我現在怎麼看「一小時生成100支影片」?
做完這次實驗之後,我對 YouTube 上常見的「一小時做100支 AI 影片」有了完全不同的理解。
真正值得追求的,不應該是:一小時呼叫 Veo 100 次。
而應該是:一小時規劃100支內容,再讓 AI 判斷其中哪些用 Canva、哪些真人拍、哪些真的值得 AI 生成。
假設規劃 30 支內容,最後可能是 18 支 Canva、7 支真人素材、5 支 AI 候選,再經二次審核之後,也許真正值得 Veo 的只有 3 支。
這種方式雖然「AI生成數量」變少了,但成本更低、內容更自然,也比較不會做出大量看起來都差不多的 AI 流水線影片。
Tina這次最大的心得
這次最大的收穫,其實不是我做出了一個會生影片的 Skill,而是我開始把 AI 當成一個「製作流程」來看,而不是一個「按下去就什麼都做完的工具」。
Gemini 擅長生成與延續畫面,Veo 擅長補動作,FFmpeg 擅長快速轉檔,Canva 擅長提供大量通用 B-roll,而品牌商品最終還是真人素材最可靠。
把每個工具放在最適合的位置,反而比逼所有事情都由 AI 完成有效得多。
目前 Tina Short Video Skill 已經從最早的單支生成,進化到 v1.1:可以簡短呼叫、避免內容重複、先提案再執行、批次工作單、素材來源分流、AI 二次審核,以及批次中斷後斷點續跑。
這個版本我打算先停在這裡,實際使用一陣子再決定下一步。
因為我現在越來越相信:AI 自動化不是功能越多越好,而是最後我需要親手做的事情越少、浪費的成本越少,而且輸出的東西真的能用,才叫成功。