

上一篇,我整理了自己這一陣子實際測試的:Codex + HyperFrames 錄音轉知識短片工作流,從一段 MP3 錄音開始,轉逐字稿、切 Scene、安排字幕、加入知識卡、做動畫、最後輸出 MP4。
做到這裡之後,照理說影片已經可以看了。但是我自己看著看著,又開始覺得:「畫面好像還少了一個『人』。」
因為我的內容本來就是知識型。如果整支影片只有:字幕、知識卡、圖示、插畫、流程圖,雖然資訊很完整,卻還是有一點像:會動的教學簡報。
所以我開始想:如果在左下角放一個小小的講師呢?就像很多線上課程一樣,畫面大部分還是知識內容,但是角落有一位講師跟著聲音說話,這樣觀眾會不會比較有陪伴感?
問題是:我自己又不想露臉,那最自然的答案就變成:AI 數字人。
我手上其實已經有兩個重要素材
這一次我不是從零開始。我已經有:一張 AI 講師圖片。還有:tina-test.mp3
也就是說:「長什麼樣子」有了、「要講什麼」也有了,剩下的問題就是:怎麼讓這張 AI 講師圖片真的跟著錄音說話?
我一開始其實也會直覺想:Codex 不是什麼都能做嗎?那乾脆叫 Codex 自己把照片變成數字人影片?
後來做下去,我才發現:這不是最合理的分工方式。
第一個重要觀念:Codex 不是數字人生成引擎
Codex 很強的地方,是:理解任務、讀檔案、寫程式、整理流程、調整畫面、協調不同工具。
但是把一張人物照片變成:嘴型自然、眼睛會動、表情自然、頭部微微晃動,而且還要和語音同步,這本身就是一個非常專門的 AI 任務。
它需要的不是普通 HTML 動畫,而是:Talking Avatar / Lip Sync / Digital Human 模型。
所以這一段,應該交給真正專門做數字人的平台。
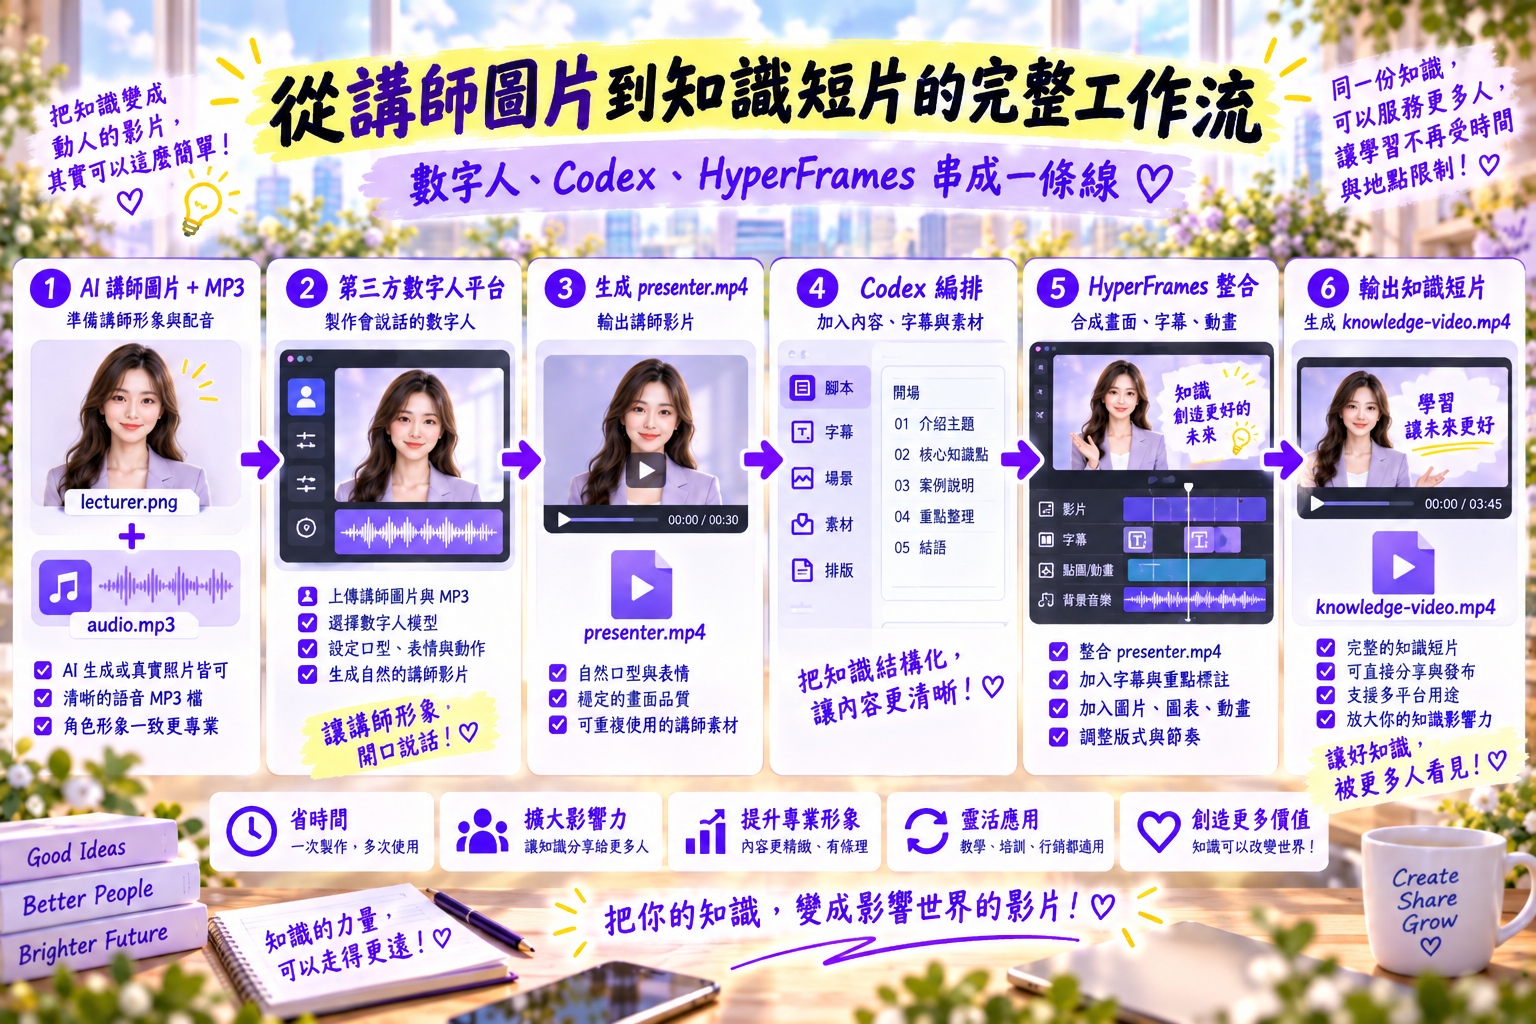
第三方平台的角色:負責把「照片+聲音」變成會說話的人
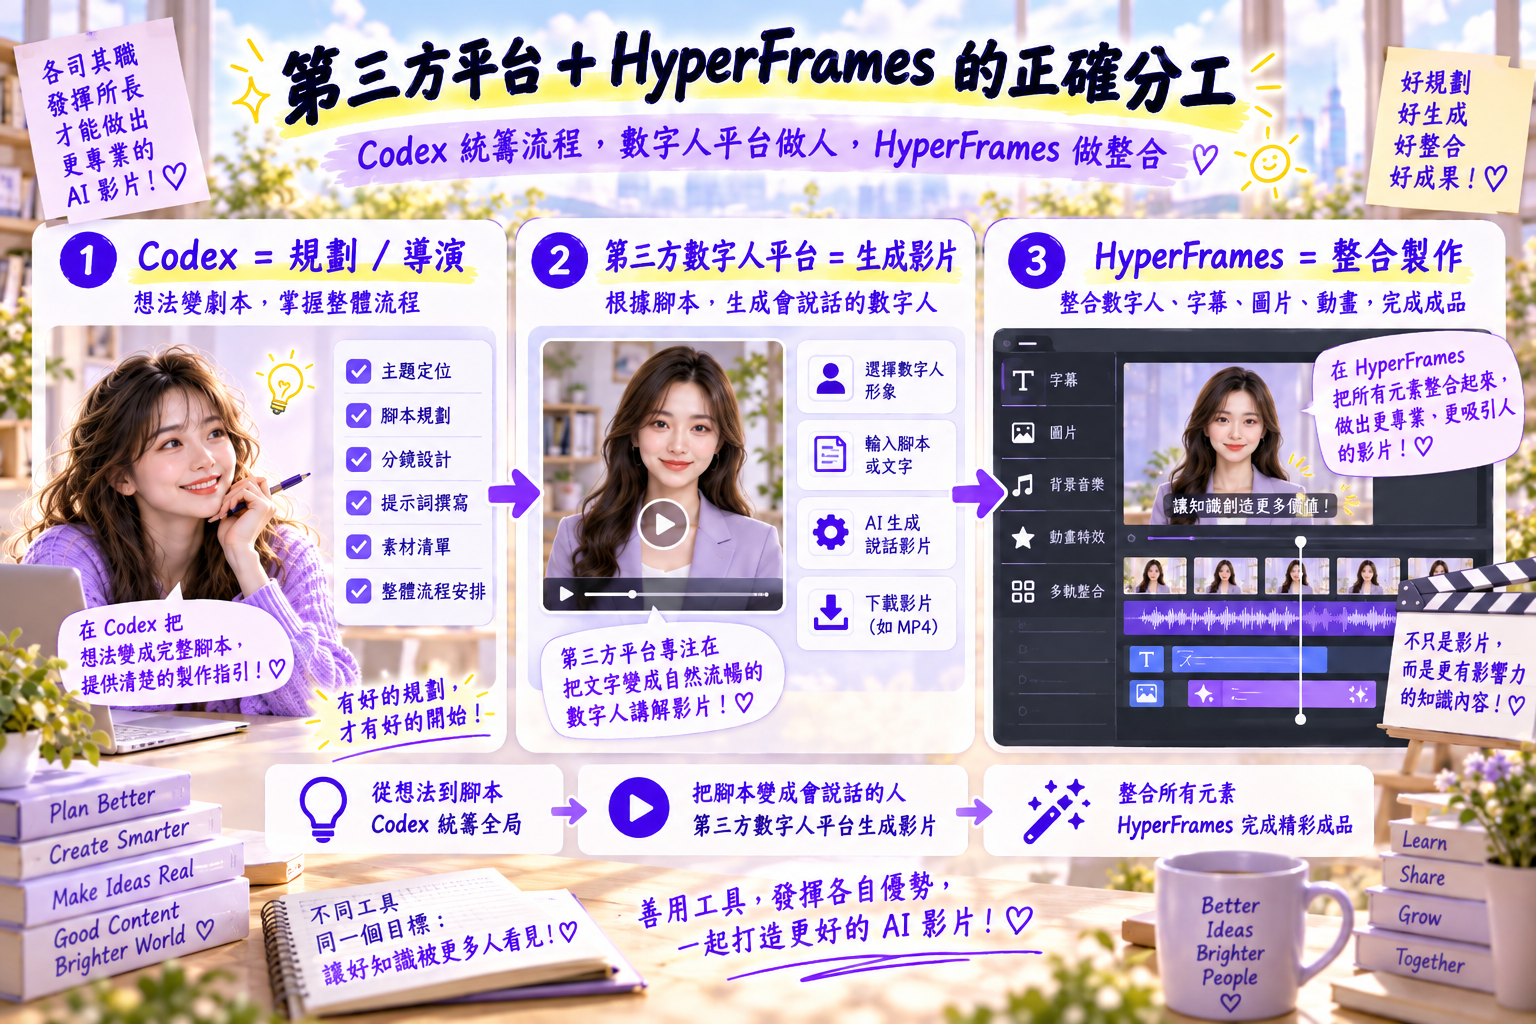
我現在會把第三方數字人平台想成:演員工廠。
我交給它:AI 講師圖片、錄音。
它負責產生:presenter.mp4,也就是一支:AI 講師跟著錄音說話的影片。
例如我這次就是想把:AI 講師圖+tina-test.mp3 先轉成:presenter.mp4
這個 presenter.mp4 本身,不需要是一支完整知識短片。
它只需要做好一件事情:把「講師」演好。
所以第三方平台不需要負責整支知識短片
這一點我覺得很重要。
因為一開始很容易變成:既然數字人平台能做影片,乾脆整支都讓它做。
但是我的知識短片裡面還需要:字幕、重點字、知識卡、插畫、流程圖、動畫、Scene 切換、品牌標頭、CTA。這些事情如果全部塞給數字人平台,反而會失去原本 HyperFrames 的優勢。
所以比較合理的做法是:數字人平台只負責人。HyperFrames 負責整支影片。
我現在會把三者分工成這樣
| 工具 | 主要工作 |
|---|---|
| Codex | 總導演/流程設計/檔案管理/修改程式/協調工作流 |
| 第三方數字人平台 | 把 AI 講師圖片+錄音,產生會說話的 presenter.mp4 |
| HyperFrames | 把 presenter.mp4、字幕、圖片、知識卡與動畫整合成最後影片 |
這樣一分,整個問題突然就簡單很多。
如果把它比喻成拍片,就更好懂
Codex 是:導演。第三方數字人平台是:演員。HyperFrames 是:攝影棚+剪輯台+Motion Graphics 系統。
導演不需要自己變成演員,演員也不需要自己剪整支影片,每個工具只做它最擅長的部分,我覺得這才是真正合理的 AI 工作流。
第一步:先準備 AI 講師圖片
數字人影片要好看,第一個最基本的東西,就是:講師圖片本身要適合動畫。
我現在會特別注意:
-
- 正面或微微側面
- 臉部不要被頭髮遮太多
- 嘴巴清楚
- 眼睛清楚
- 光線均勻
- 背景不要太亂
- 肩膀最好有完整保留
如果圖片一開始就:臉很小,嘴巴被手遮住,側到幾乎看不到另一邊臉,那後面 Lip Sync 再厲害,也比較容易怪。
AI 講師不一定需要全身
因為我這次想做的,不是:一位老師站在正中央講 15 秒。
我的想法比較像:左下角小圓形講師視窗。或者:左側半身 Presenter。
因此圖片只要:頭、肩膀、一點上半身,其實就夠了。這樣數字人影片產生後,還比較容易塞進 HyperFrames 的版面。
第二步:把錄音交給數字人平台
這一段最單純。我希望 AI 講師講什麼,就使用:tina-test.mp3 這樣有一個很大的好處。
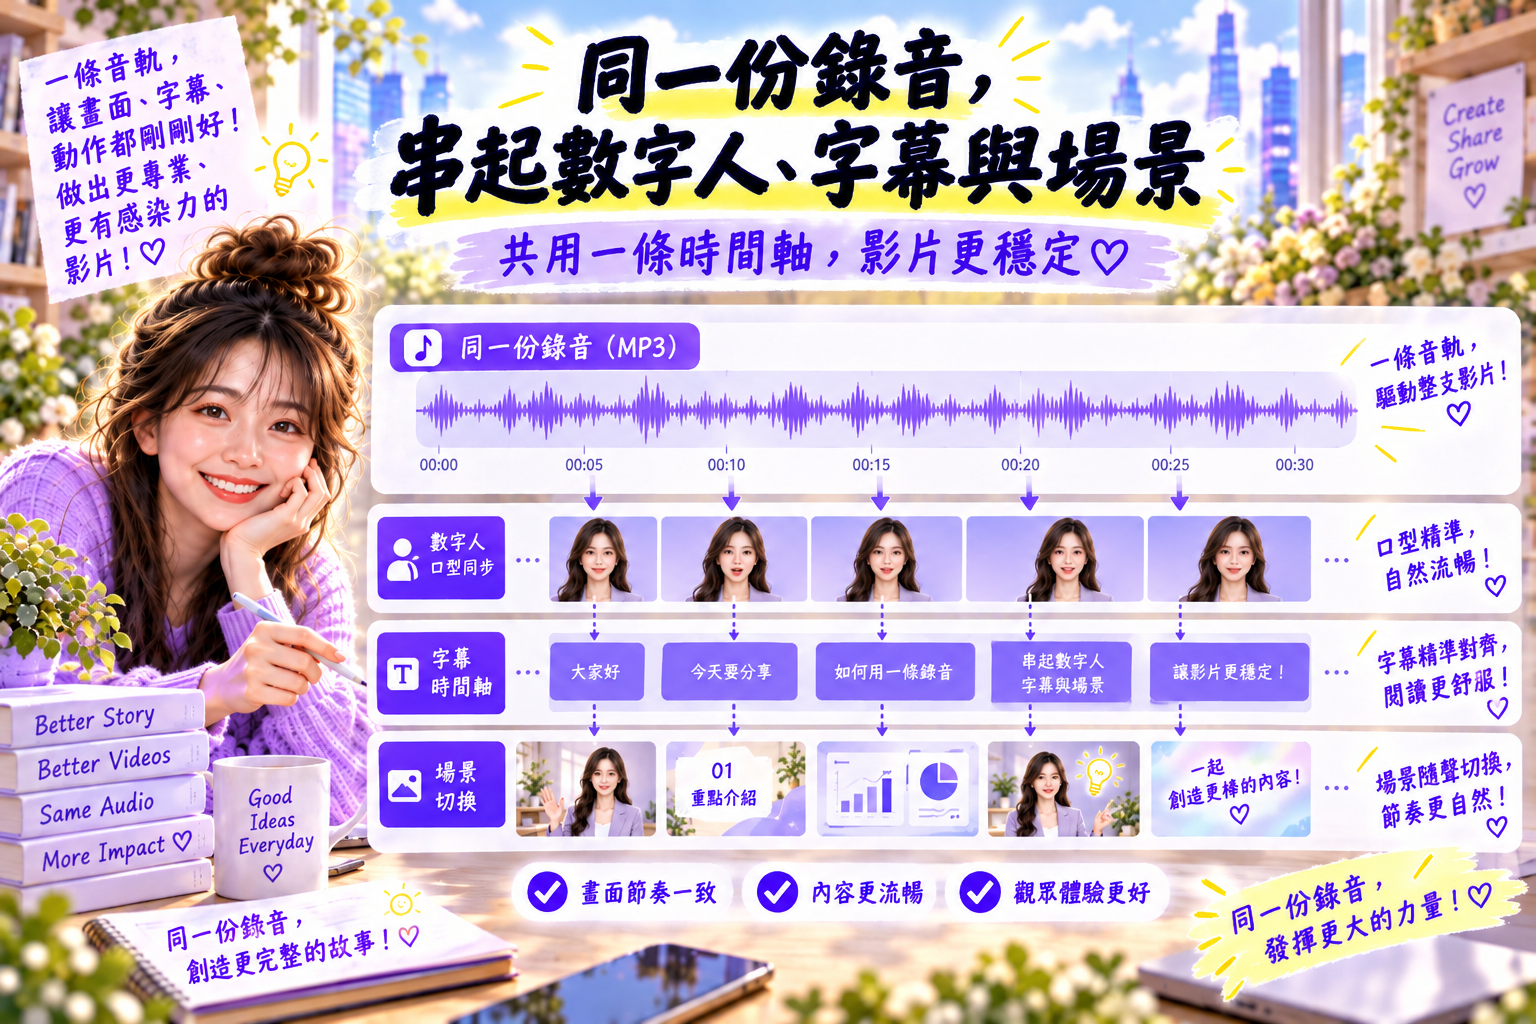
上一篇 HyperFrames 的字幕和畫面,本來就是依照同一份錄音做的,現在數字人也使用同一份錄音。也就是:所有東西共用同一條時間軸。這件事非常重要。
為什麼我不建議另外讓數字人平台重新產生 AI 語音?
不是不能。
而是如果我的原始影片已經以 tina-test.mp3 為基準:字幕是照它切的、Scene 是照它切的、動畫也是照它切的,結果數字人突然改用另一個 AI Voice。
就可能出現:講話速度不同、停頓不同、句子長度不同、整個時間軸重新跑掉。
所以對我目前這套工作流來說,最乾淨的是:同一份錄音,從頭用到底。
第三步:產出 presenter.mp4
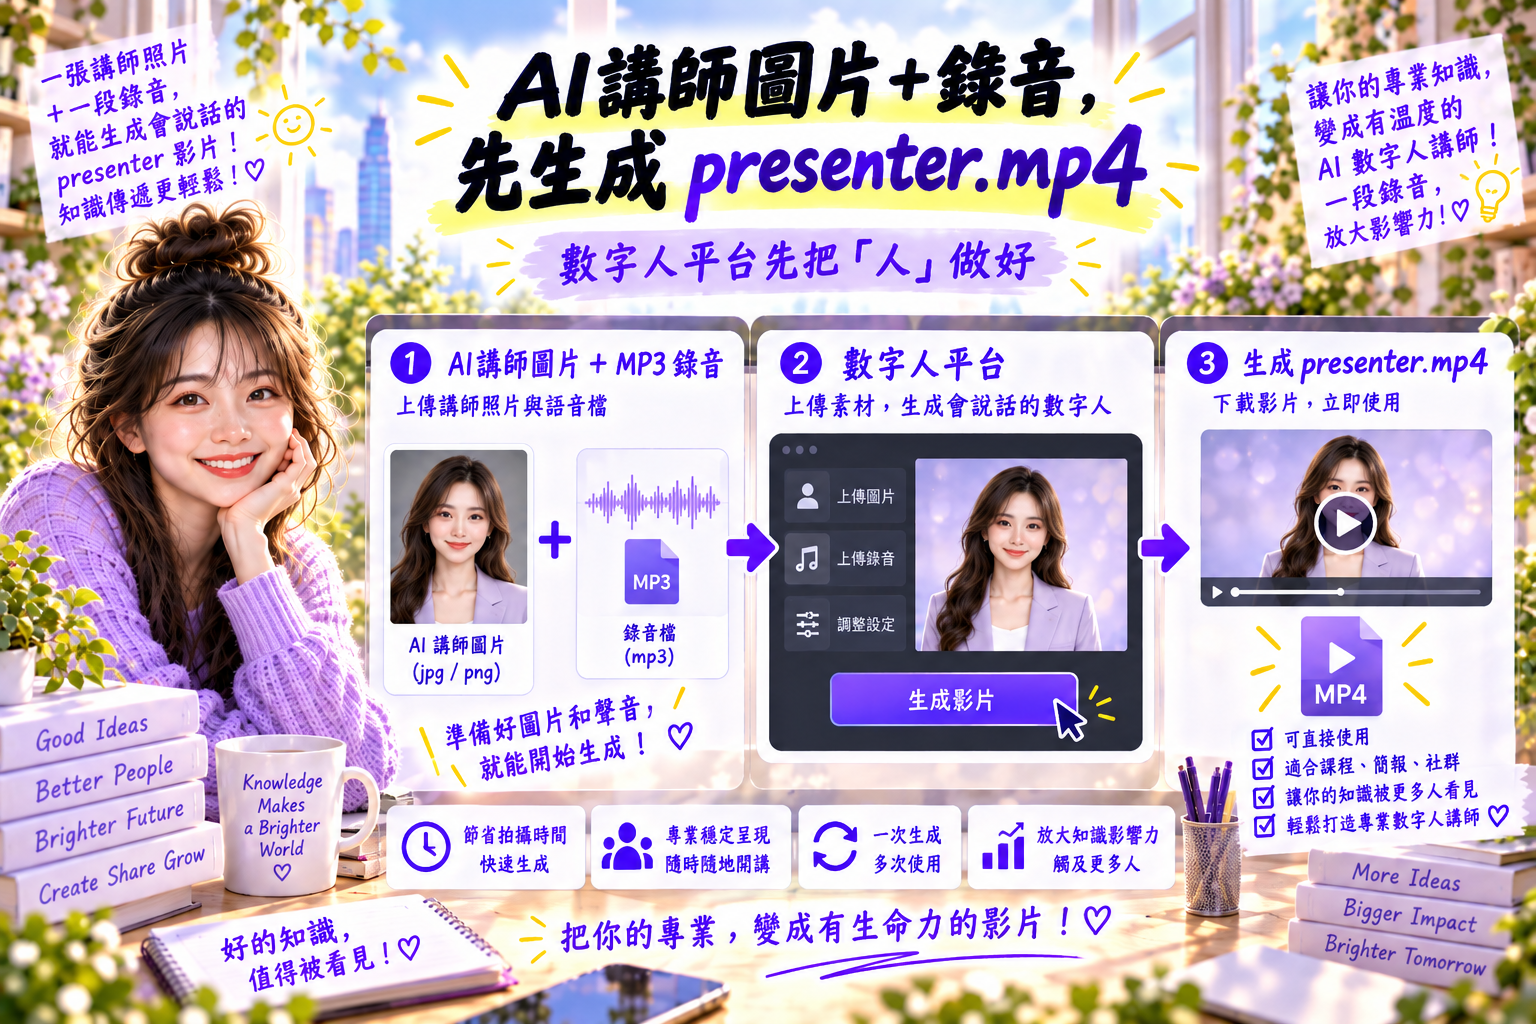
數字人平台最後真正要交回來的,就是:presenter.mp4
這個檔案我會把它視為:素材,它不是 Final Video,這個觀念一定要分清楚。
就像做真人影片時:我先拍一段老師講話、這段老師影片只是素材。
後面還要:排版、加字幕、加 B-roll、加動畫、加圖卡,最後才變成成品。AI 數字人其實也一樣。
如果平台支援透明背景,當然最好
如果數字人平台可以直接輸出:透明背景,那後面會非常方便。
因為 presenter 可以直接疊在知識卡上,不需要再處理矩形背景。
但如果平台輸出的只是一般背景影片,也不是不能用。
可以:先使用乾淨單色背景、後續再做去背、或者乾脆把 Presenter 放進一個:圓形視窗。這也是我自己很喜歡的做法。
我為什麼喜歡「左下角小圓講師」?
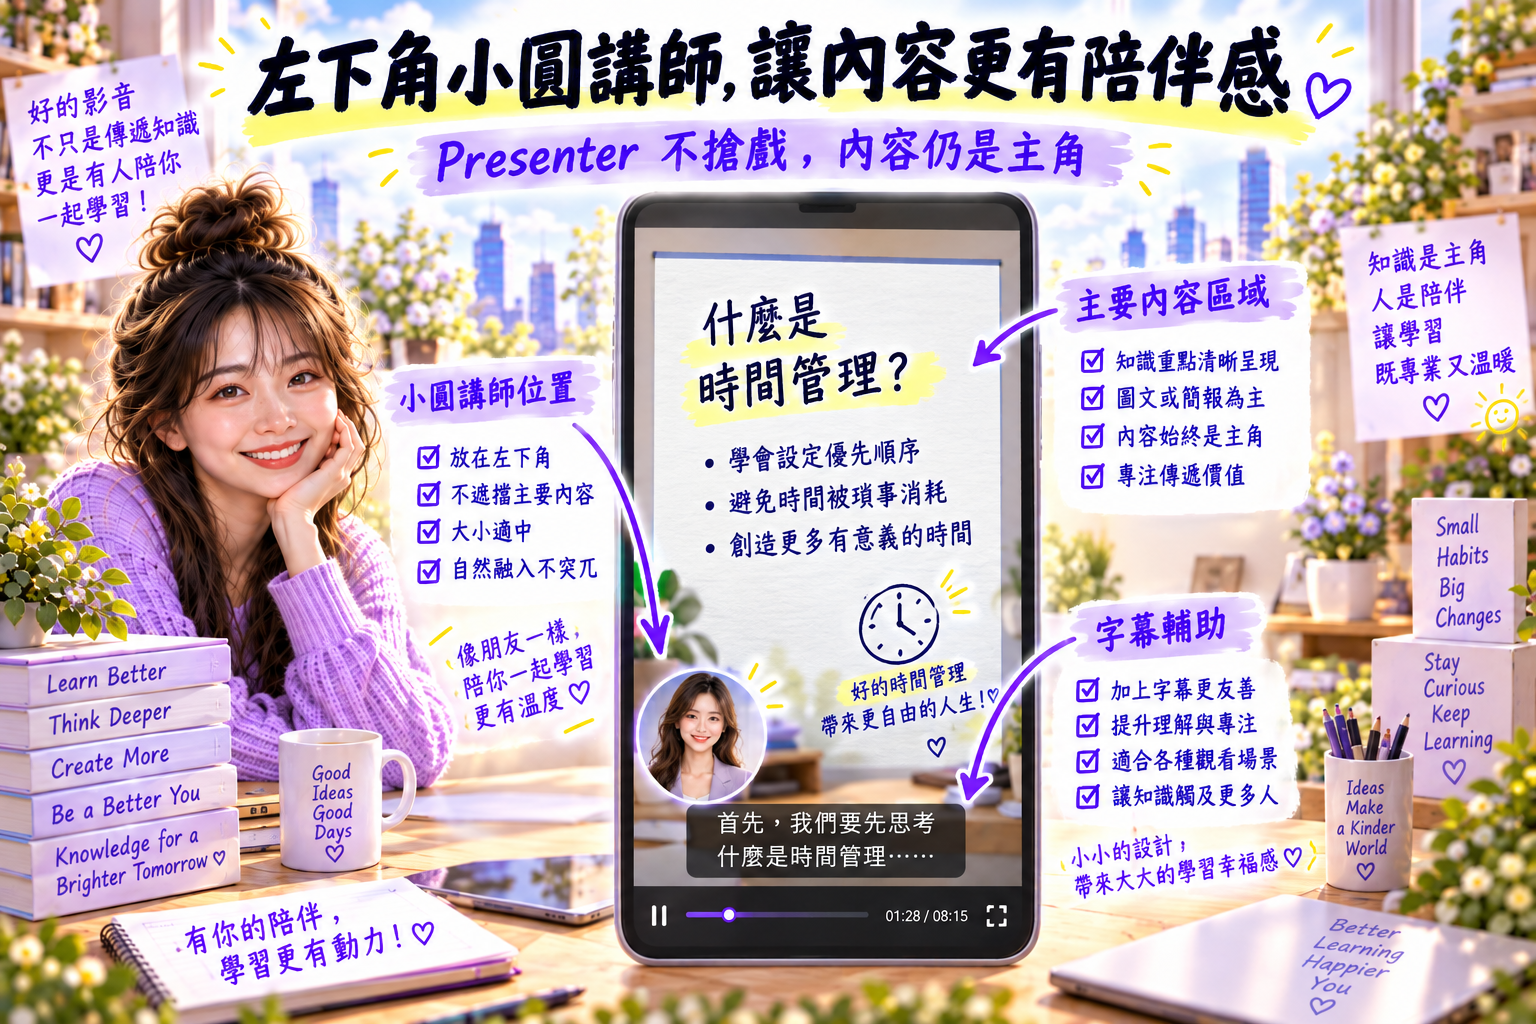
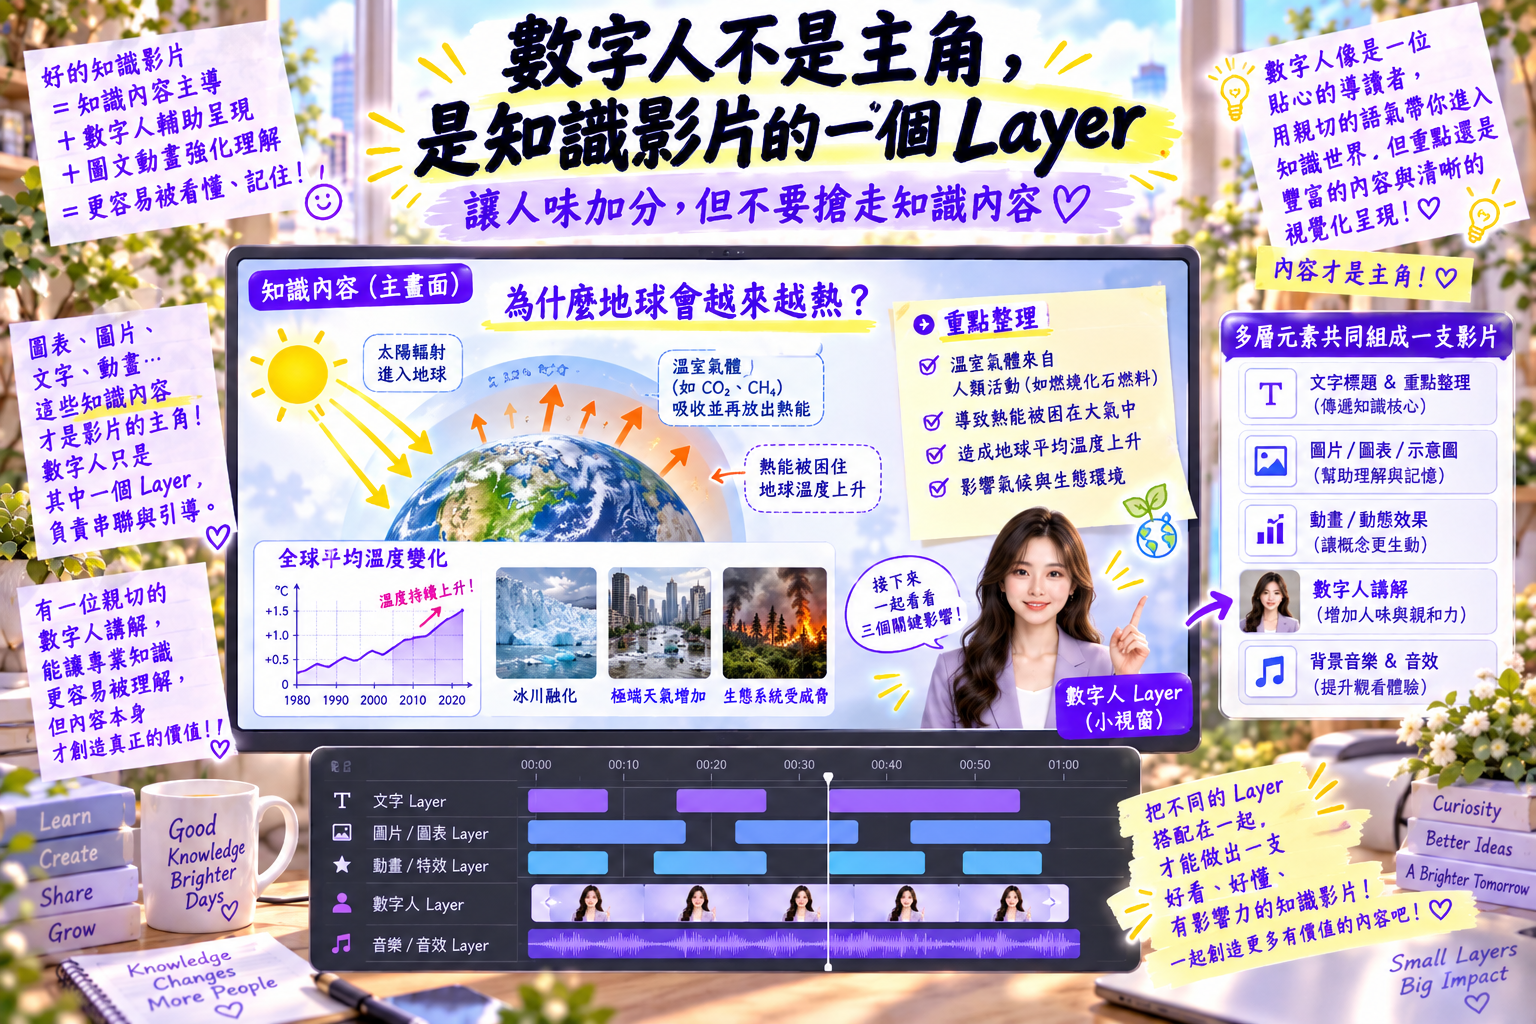
因為知識影片真正的主角,還是:知識內容,不是數字人。
如果 AI 講師佔滿整個畫面,會變成:觀眾一直看人。但是流程圖、插畫、知識重點都只能縮小。這樣反而本末倒置。
所以我目前比較喜歡 畫面中央或上方:主知識區。畫面底部:字幕區。左下角:小圓形 AI 講師。這樣三者不會搶位置。
但是這裡馬上又遇到新的版面問題
以前沒有 Presenter 時,左下角可能可以放:圖片、流程、裝飾。
現在多了一個數字人,整個 Safe Area 都要重新想。
尤其我們前面又已經決定:字幕要貼底。如果 Presenter 也貼底,就會撞到字幕。
所以不能只是:「把一支 presenter.mp4 疊上去。」還要重新設計:Presenter Safe Zone。
我現在會把直式影片大致分成三個安全區
| 區域 | 主要內容 |
|---|---|
| 上方/中央 | 知識主畫面、插畫、流程圖、標題 |
| 左下或右下 | AI Presenter |
| 最底部 | 字幕 |
Presenter 必須高於字幕、字幕必須低於主要畫面、三層都不要互相蓋住。
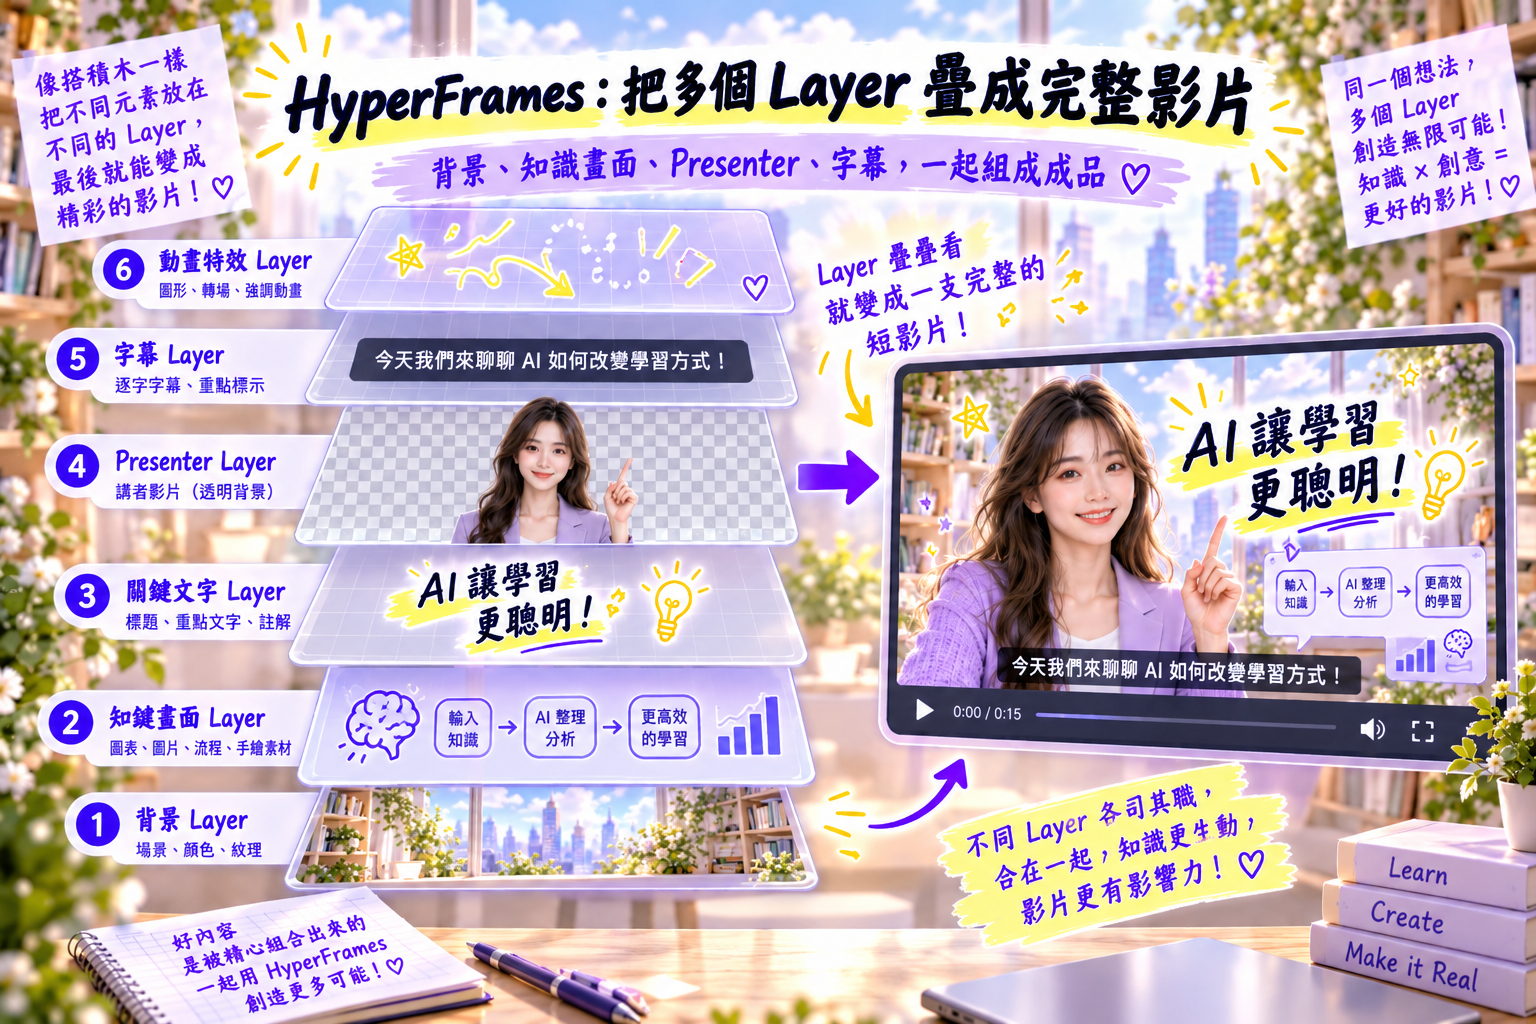
HyperFrames 的角色,就是把這些 Layer 疊在一起
這就是 HyperFrames 開始真正重要的地方。
假設目前有:
background.jpg
presenter.mp4
illustration.png
captions.json
audio.mp3
HyperFrames 要做的,就是把它們變成:
Layer 1:背景
Layer 2:知識圖片
Layer 3:重點文字
Layer 4:AI Presenter
Layer 5:字幕
Layer 6:裝飾動畫
然後再放進同一條 Timeline。
這樣 Presenter 不再是一支獨立影片,它只是一個:Video Layer。
這時 AI 數字人就跟圖片、字幕一樣,只是一個 Component
這個觀念我覺得非常重要。
一開始看到數字人,會很容易覺得:「哇,這個東西好高科技,整支影片是不是都要繞著它做?」
但真正成熟的工作流,反而應該把它降級成:一個可以開、關、換位置、換大小的 Component。
例如 Scene 1:Presenter 出現。Scene 2:Presenter 暫時縮小。Scene 3:Presenter 再出現做 CTA。
這樣會比 15 秒從頭到尾都黏在左下角更有節奏。
數字人不一定要全程出現
這也是我後來越想越覺得合理的做法。
如果一支 15 秒知識片,數字人 15 秒都在講:看久了其實還是會單調。
反而可以這樣:
| 時間 | 數字人安排 |
|---|---|
| 0–5 秒 | Presenter 出現,建立人物連結 |
| 5–10 秒 | Presenter 縮小或離場,讓圖解成為主角 |
| 10–15 秒 | Presenter 再出現,做結論或 CTA |
這樣畫面反而更像:真的有人在帶著觀眾上課。
第四步:Codex 負責安排 Presenter 什麼時候出場
這就是 Codex 最適合做的地方。
它可以讀:逐字稿、Scene、presenter.mp4、字幕。
再依照規則決定:講師從第幾秒進場、放左邊還右邊、多大、哪一段要縮小、哪一段要離場、CTA 時要不要再放大。
這才是 Codex 真正擅長的:編排。
Codex 不必製造 Presenter,它只要會「使用 Presenter」
我覺得這句話非常值得記下來。
Codex 不需要負責生成每一種素材,但它要知道怎麼使用不同素材。
就像前面的產品銷售頁,Codex 不需要自己拍 Dosha 產品照。
但它要知道:哪張是產品主圖、哪張是情境圖、哪裡應該使用。
影片也是同一個概念,Codex 不需要自己生成數字人。
但是它需要知道:presenter.mp4 是什麼,以及應該怎麼放。
第五步:字幕還是由 HyperFrames 統一控制比較乾淨
這裡也很容易重複。因為有些數字人平台本身也能燒字幕。
可是如果 presenter.mp4 已經自帶字幕,然後 HyperFrames 又放一次字幕,就會變成:兩套字幕。
這一定很亂。
所以如果目標是把 Presenter 當素材,我反而會傾向:數字人平台只輸出人物影片,不要把完整影片 UI 一起做死。
字幕統一交給 HyperFrames。這樣位置、字體、大小,一句一句出現,全部跟第 16 篇的字幕規則共用。
同一條錄音,也能避免嘴型和字幕不同步
如果:數字人用 tina-test.mp3。HyperFrames 字幕也用 tina-test.mp3。整個影片時間軸也以 tina-test.mp3 為準。
那理論上:Presenter、字幕、動畫、Scene,都在同一條時間上。
這會比:數字人一套錄音、字幕另一套文字、動畫又自己估時間,穩定很多。
這次我真正想做的畫面,大概就是這樣
┌───────────────────────────┐
│       主知識畫面           │
│                           │
│   圖片 / 流程 / 重點動畫   │
│                           │
│ ○ AI講師                  │
│                           │
│      字幕一句一句出現       │
└───────────────────────────┘
AI 講師不是最大、字幕也不是最大、真正最大的仍然是:知識。
Presenter 的尺寸不是越大越好
一開始看到數字人,當然會很想把它做大,不然好像浪費。
但這支影片不是:AI 主播新聞,也不是:純數字人口播。而是:知識動畫影片。
所以 Presenter 只要讓觀眾知道:「有人正在帶我理解這件事。」其實就夠了。
我會特別避免 Presenter 擋到哪些東西?
至少有四種。
1. 字幕
最重要。所以 Presenter 不能太貼底。
2. 重點文字
如果一段正在 Highlight 關鍵字,不要讓人物剛好擋住。
3. 流程箭頭
知識型影片很多流程圖。Presenter 擋住箭頭,觀眾會突然看不懂。
4. CTA
最後一段如果有 CTA,位置要先預留。
所以 Presenter 也要有自己的 Safe Zone 規則
例如:
Presenter Safe Zone:
- 不得進入字幕區
- 不得遮住 H1 / Key Point
- 不得遮住流程主線
- 預設放左下或右下
- Scene 可調整大小
- 必要時可暫時離場
當這些規則先定義好,後面就比較適合自動化。
第六步:數字人影片也要做 QA
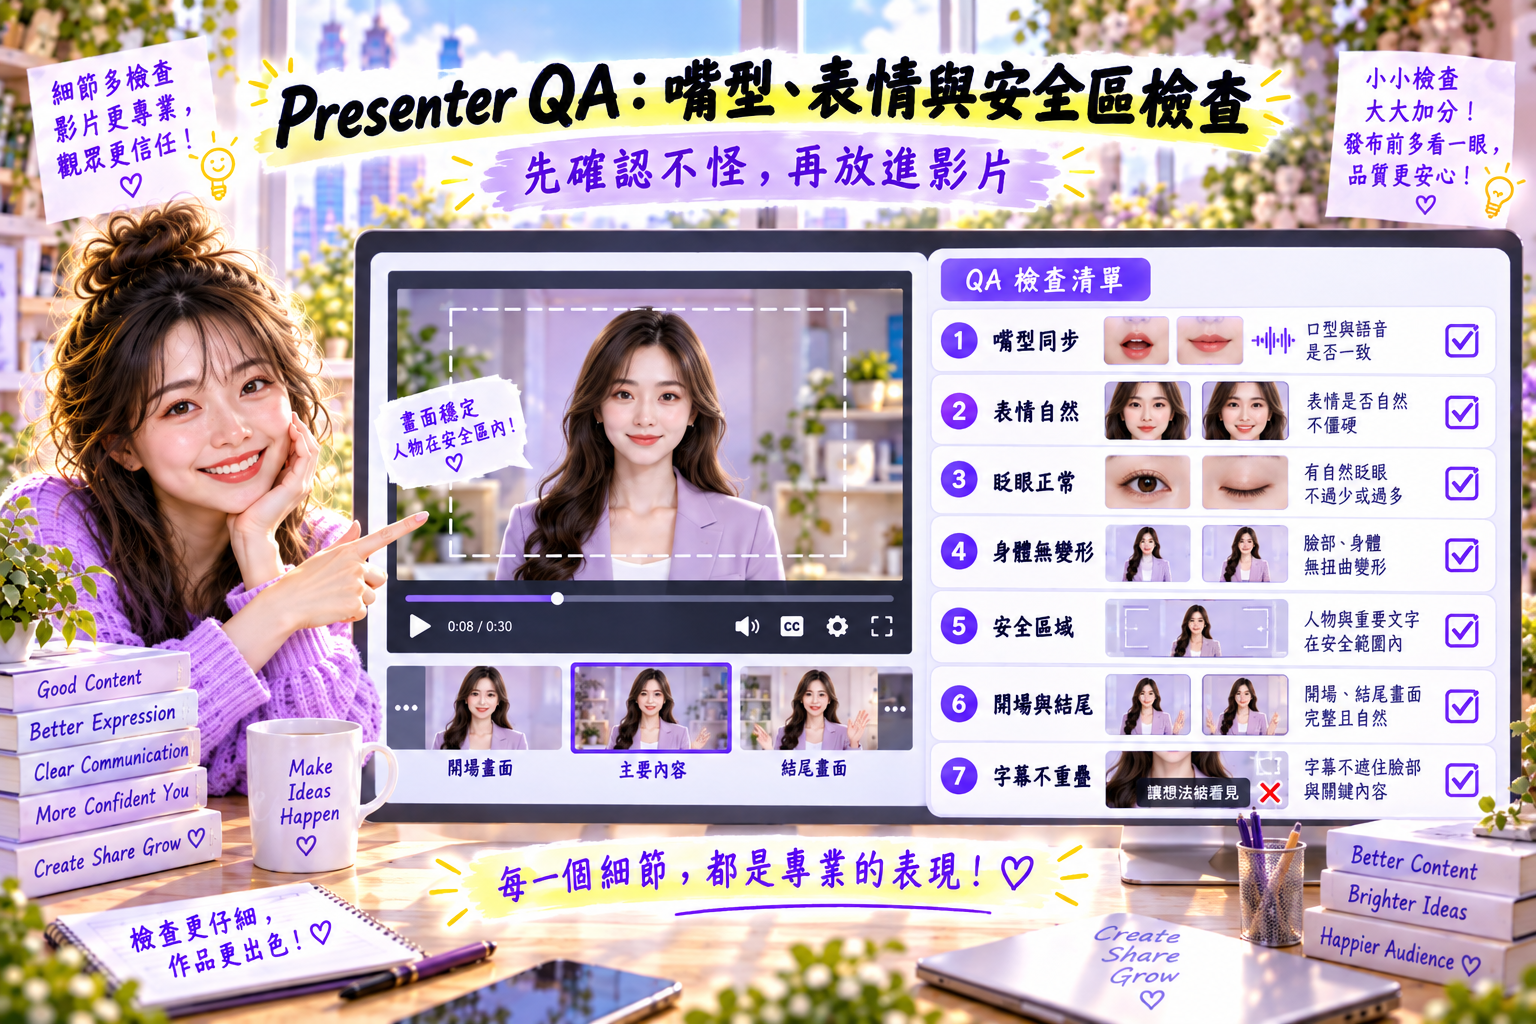
這一層不能因為「AI 已經做完」就不看。
我會特別看:
-
- 嘴型有沒有明顯不同步
- 嘴巴有沒有怪異變形
- 眨眼是否自然
- 頭部動作是不是太頻繁
- 手或身體是否出現奇怪變形
- 影片開頭是否有靜止幀
- 結尾是否突然卡住
因為如果 presenter.mp4 本身就怪,HyperFrames 再漂亮也救不了。
我現在反而不追求「像真人到看不出來」
這件事情我覺得很有趣。
以前看數字人,很容易一直問:像不像真人?嘴巴自然嗎?會不會被看出是 AI?
但做到知識短片之後,我反而覺得:這不是最重要的。
真正重要的是:不要怪、不要干擾、不要搶內容,讓觀眾覺得有人陪他理解。如果做到這樣,我覺得就夠了。
AI 講師反而很適合我這種不露臉的內容工作流
這也是我為什麼會一直想測數字人的原因。
因為如果要我自己:化妝、架燈、架相機、錄 30 支、重講、剪掉 NG,這對我的工作方式並不適合。
但如果我可以:先錄音、準備一張固定 AI 講師圖、數字人平台幫我產 presenter.mp4、Codex 再自動組合,那整個門檻就完全不一樣。
更重要的是:同一位講師可以形成系列識別
如果每一支影片都使用:同一位 AI 講師、同一種衣服或近似風格,固定出現在相似位置。字幕也一致、色彩也一致,觀眾久了就會開始建立辨識。
也就是:Presenter 本身也開始變成品牌的一部分。
所以 AI 數字人其實也需要 Presenter DNA
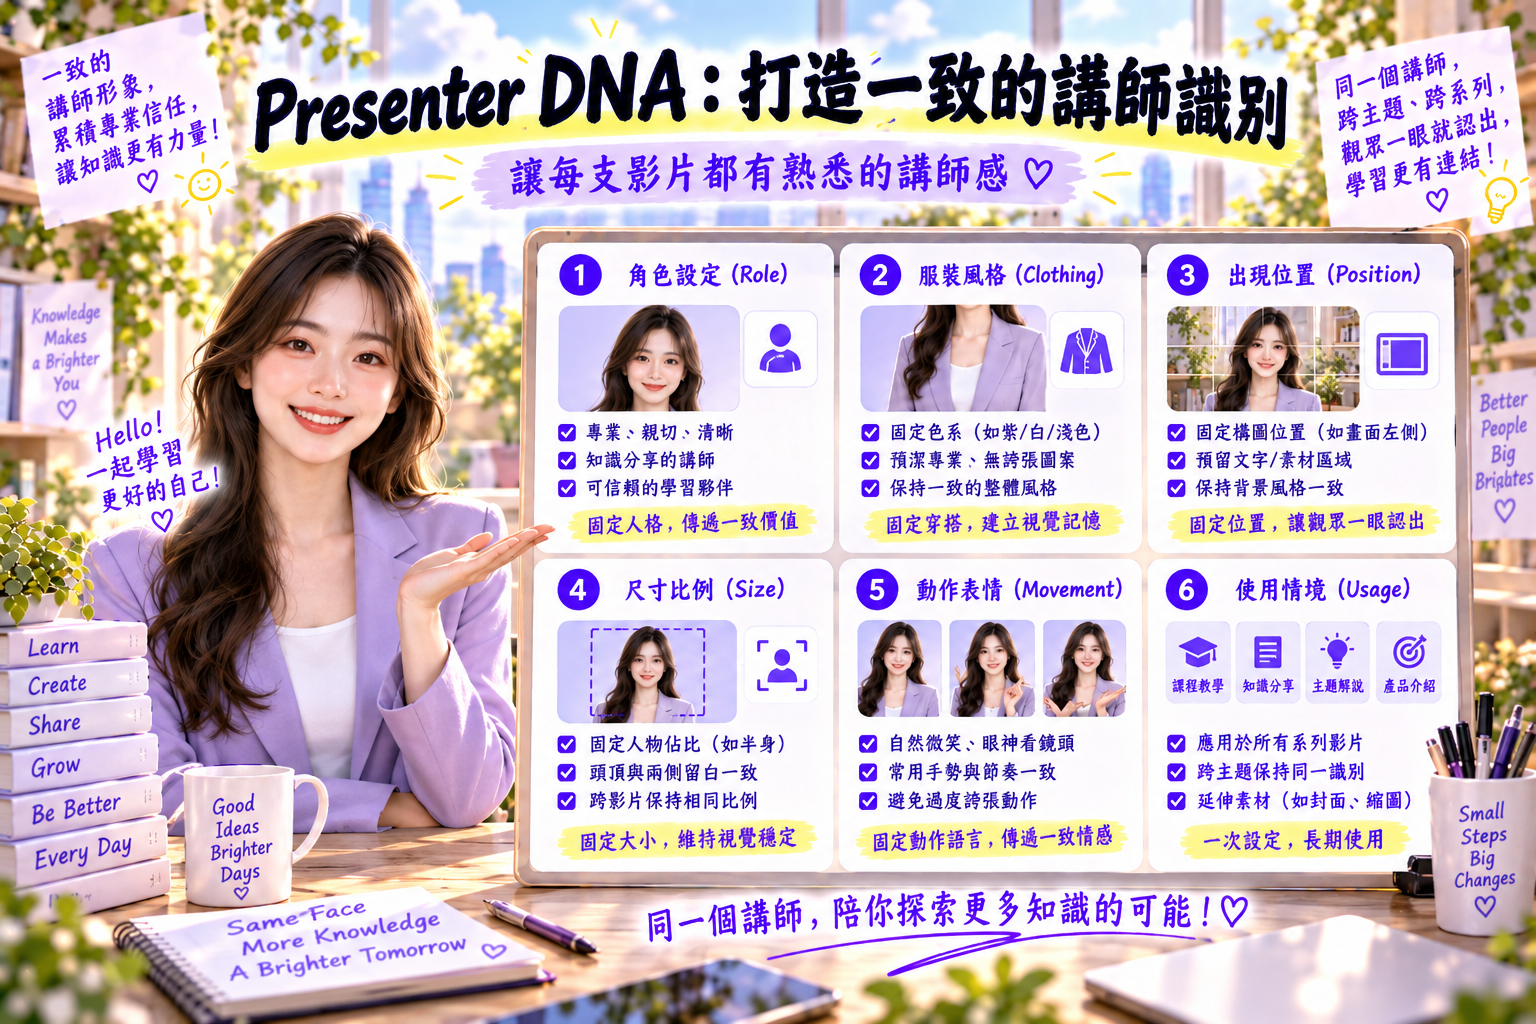
做到這裡,我甚至開始覺得:可以像前面網站的 Brand DNA 一樣,替影片的講師也定義一套:Presenter DNA。
例如:
| 項目 | 規則 |
|---|---|
| 角色 | 知識型 AI 講師 |
| 服裝 | 簡潔、專業、不過度正式 |
| 出現位置 | 左下為主 |
| 尺寸 | 不超過主知識畫面的視覺權重 |
| 動作 | 自然、少量、不搶戲 |
| 用途 | 開場、轉折、結論、CTA |
這樣未來每一支影片就不需要重新決定。
Presenter 也可以變成 Skill 裡的一個選項
例如以後整套影片 Skill 可以有:
presenter:
  enabled: true
  position: bottom-left
  size: small
  appear_in:
    - intro
    - outro
或者某些影片:
presenter:
  enabled: false
這時數字人就不再是一個很神秘的 AI 功能。而是:影片模板裡的一個開關。
這才是我真正想要的自動化
不是每次:上數字人平台、下載、打開剪映、去背、縮小、拖到左下角、再調字幕,下一支再重新做一次。
我真正想要的是:只要 presenter.mp4 出現,Codex 就知道:這是一位講師。HyperFrames 就知道:要把它疊到固定位置。字幕也知道:要避開 Presenter。
這樣才叫:Workflow。
整套 AI 數字人影片流程,我現在會畫成這樣
AI 講師圖片
        +
tina-test.mp3
        ↓
第三方數字人平台
        ↓
presenter.mp4
        ↓
Codex 讀取 Presenter+逐字稿+Scene
        ↓
決定 Presenter 出場規則
        ↓
HyperFrames
        ↓
背景+知識畫面+動畫+Presenter+字幕
        ↓
Preview / QA
        ↓
Final Render
        ↓
knowledge-video.mp4
這個流程我覺得已經很清楚地說明:第三方平台不是競爭者,而是素材供應者。
不要讓每一個 AI 工具都想包辦全部
這其實是我這次最大的體會。現在 AI 工具很多。
每一個都會說:可以寫、可以剪、可以做影片、可以做 Avatar、可以自動化。
如果我一直想找:「一個工具全部做完。」最後反而可能每一段都普通。
真正比較合理的方式是:嘴型同步最強的工具,做數字人。流程與程式最強的 Codex,做協調。畫面動畫與時間軸交給 HyperFrames。每個工具都做自己擅長的 20%。最後組成一套完整的 100%。
Tina學姐這次最大的體會:AI 自動化不是找一個萬能工具,而是設計正確分工
這次做到數字人,我覺得自己對「AI Workflow」又多理解了一層。
以前我會問:「這個工具能不能做這件事?」
現在我比較會問:「這件事情,交給哪一個工具最合理?」
兩個問題看起來很像。其實差很多。
Codex 也許可以想辦法做一些 Avatar 效果。HyperFrames 也可以做人物影片 Layer。數字人平台也可以加字幕。
但不代表:它們都應該做。
真正好的 Workflow,是:邊界清楚、資料能交換、每個工具做最擅長的事,最後再由 Codex 把流程串起來。
寫在最後:AI 講師不是整支影片,它只是整個知識系統的一個 Layer
做到第 17 篇,我現在反而不會把數字人看得那麼神秘了。
它不是:「一支 AI 影片。」
它只是:Presenter Layer。錄音是 Audio Layer。字幕是 Caption Layer。插畫是 Visual Layer。Motion Graphics 是 Animation Layer。所有東西最後在 HyperFrames 裡面組起來。
而 Codex 則負責:讓這些 Layer 知道什麼時候該出現、該放哪裡、該怎麼合作。
這個觀念一旦想清楚,數字人就不再是一個需要重新發明整套流程的新專案。
它只是:在原本已經存在的錄音轉影片 Workflow 裡,多加入一個新的 Component。
我覺得這才是最有價值的地方。