

做到前面第 16~19 篇,我其實已經把這段 AI 知識短片實驗拆成很多部分。
從錄音開始,讓 Codex 分析逐字稿;再交給 HyperFrames 安排字幕、Scene、圖片與動畫;後來又加入 AI Presenter、Illustrated Storytelling,以及 Layered Motion Graphics。
如果只看最後整理出來的流程,好像很順。但真正實作時完全不是這樣。
我的影片不是第一次生成就變成現在這個樣子,而是從:v1 → v2 → v3 → v4 → v4.1,一路慢慢修上來,而且最有意思的是,很多版本其實:內容沒有換、錄音沒有換、主題沒有換,甚至字幕文字大致也沒有換。
真正一直改的,是:畫面怎麼看、字幕怎麼出現、重點放在哪裡、動畫多快,圖片扮演什麼角色。
以及觀眾到底會不會願意把這 15 秒看完。
所以這篇我想記錄的,不是「哪個 AI 最厲害」,而是 AI 影片到底怎麼一步一步修成比較像成品。
先講結論:第一版的任務,本來就不是完美
這是我做到後來才比較接受的一件事。
剛開始使用 AI 做影片時,很容易有一種期待:我都已經把需求講得這麼清楚了,錄音也給了、字幕規則也說了、動畫也要求了。
那第一次輸出,不就應該直接很好看嗎?
實際上不是!第一版更像:把想法第一次變成可以被看見的東西。
只有當影片真的播起來,我才會知道原本寫在 Prompt 裡的東西,落到畫面上到底合不合理。
例如一句:「字幕放在下方。」
真正輸出後才會發現:到底下到哪裡才叫「下方」?會不會撞到手機 UI?會不會擋 Presenter?會不會和上面的知識卡擠在一起?這些事情,光用文字其實很難完全想像。
v1:功能都有,但第一眼就是「很像 PPT」
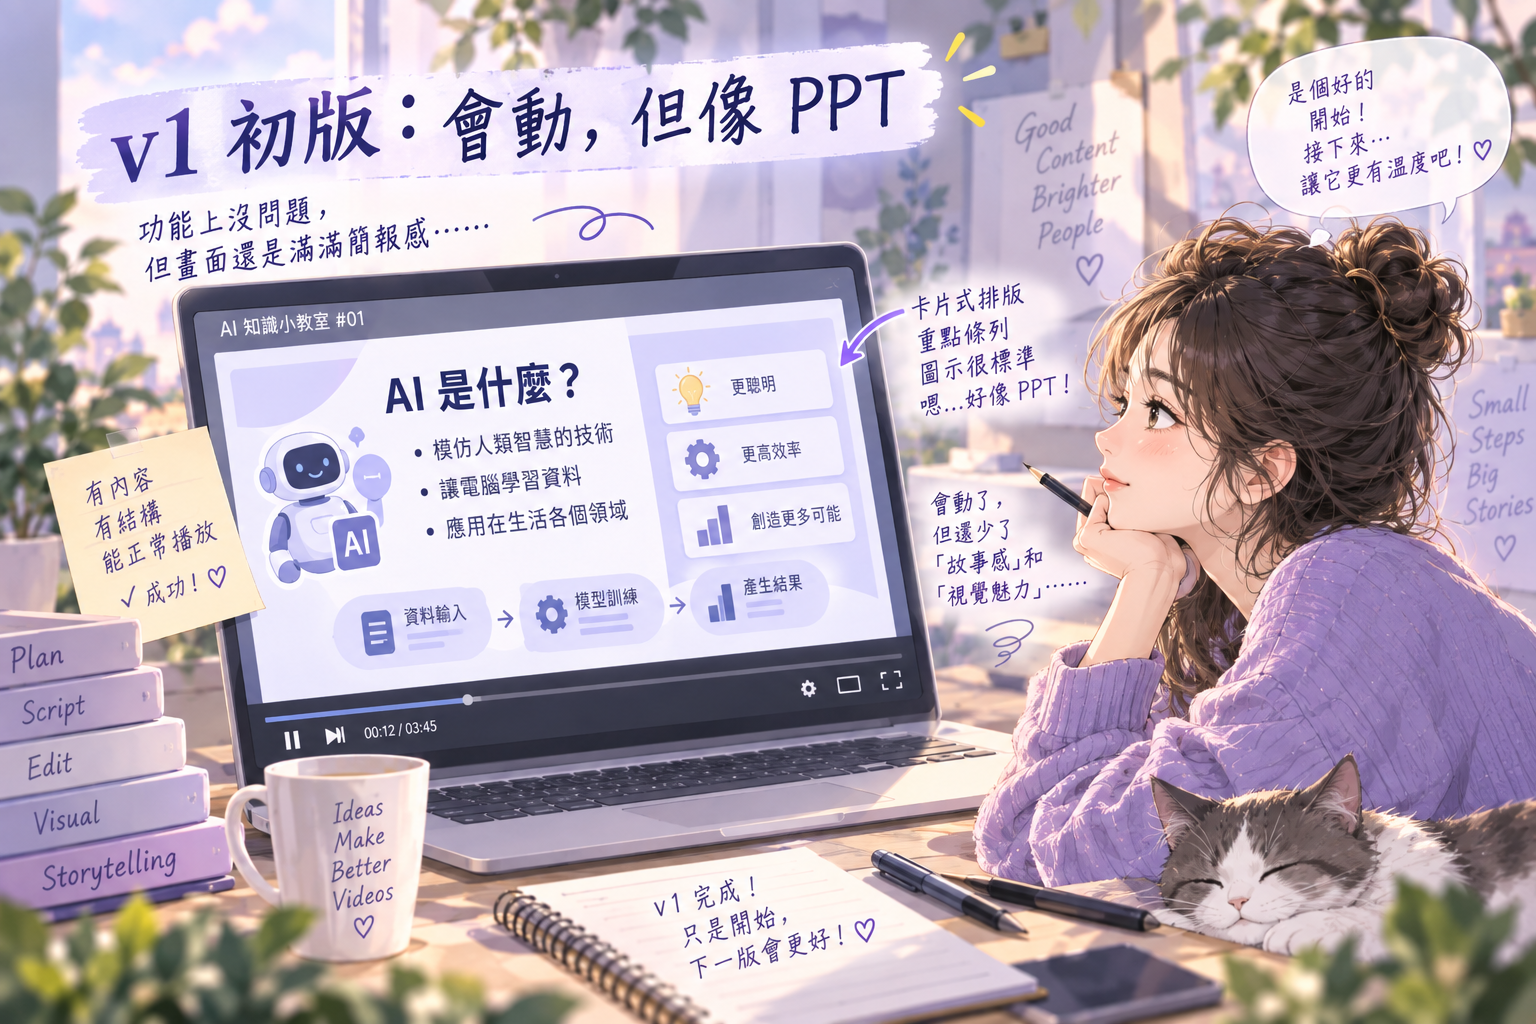
我的第一版其實不是壞掉。反而可以說:該有的功能大部分都有。
錄音正常、字幕有出現、標題有出現、知識重點也有,畫面甚至還有一些進場動畫。
但是我看完的第一個感受就是:「這是一份會動的 PPT。」
畫面主要還是:標題、方框、文字、小圖示、知識卡,然後這些元素一個一個飛進來,技術上有動畫,但觀看上沒有真的形成一個「影片」。
v1 最大的問題,不是動畫太少,而是畫面沒有真正的主角
這件事我後來才看懂。當時畫面裡什麼都有。所以反而:不知道要看哪裡。
標題在動、卡片在動、Icon 在動、字幕也在動,但這些元素彼此沒有明確的主從關係。
結果動畫越多,畫面反而越像:「我正在展示一張簡報。」
而不是:「我正在帶觀眾理解一件事情。」
v1 還有另一個非常明顯的問題:字幕太高
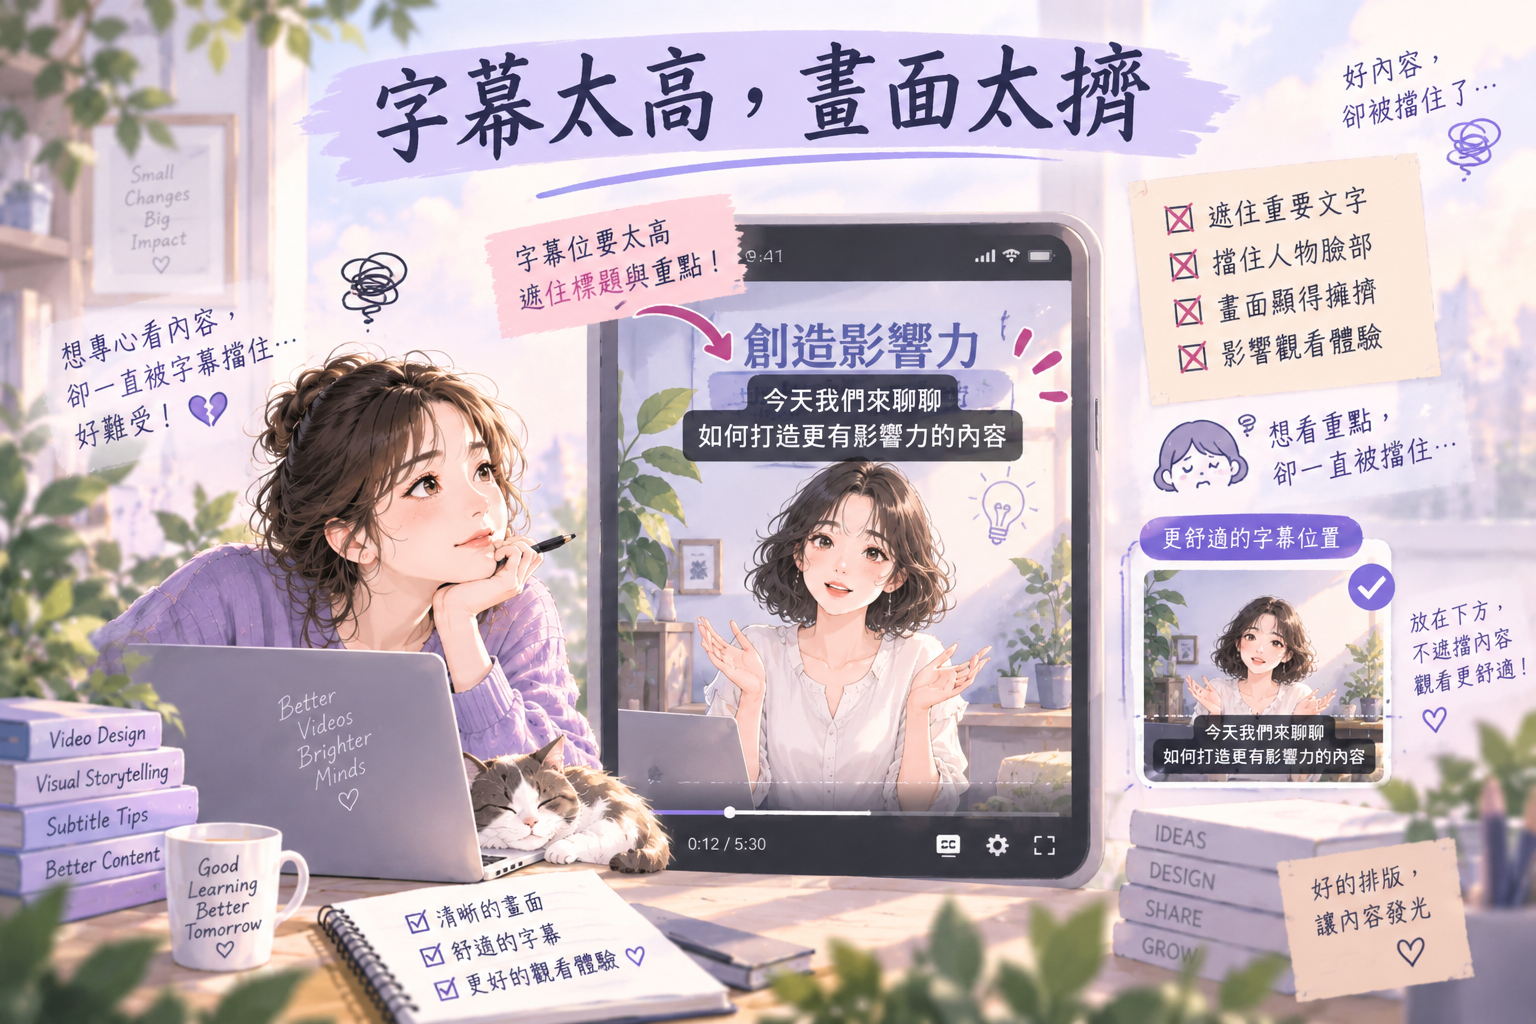
這是實際看成品之後,一眼就能發現的問題。
知識內容本來已經集中在畫面中上方,字幕又放得偏高,所以兩個區域一直互相搶空間。
尤其短片只有 9:16 的直式畫面,真正可以使用的區域其實沒有想像中那麼大。
所以 v1 給我的第一個教訓就是:字幕不是最後加上去的附件,它本身就是版面設計的一部分。
v2:先不要追求更華麗,先把「不好看」的地方整理乾淨
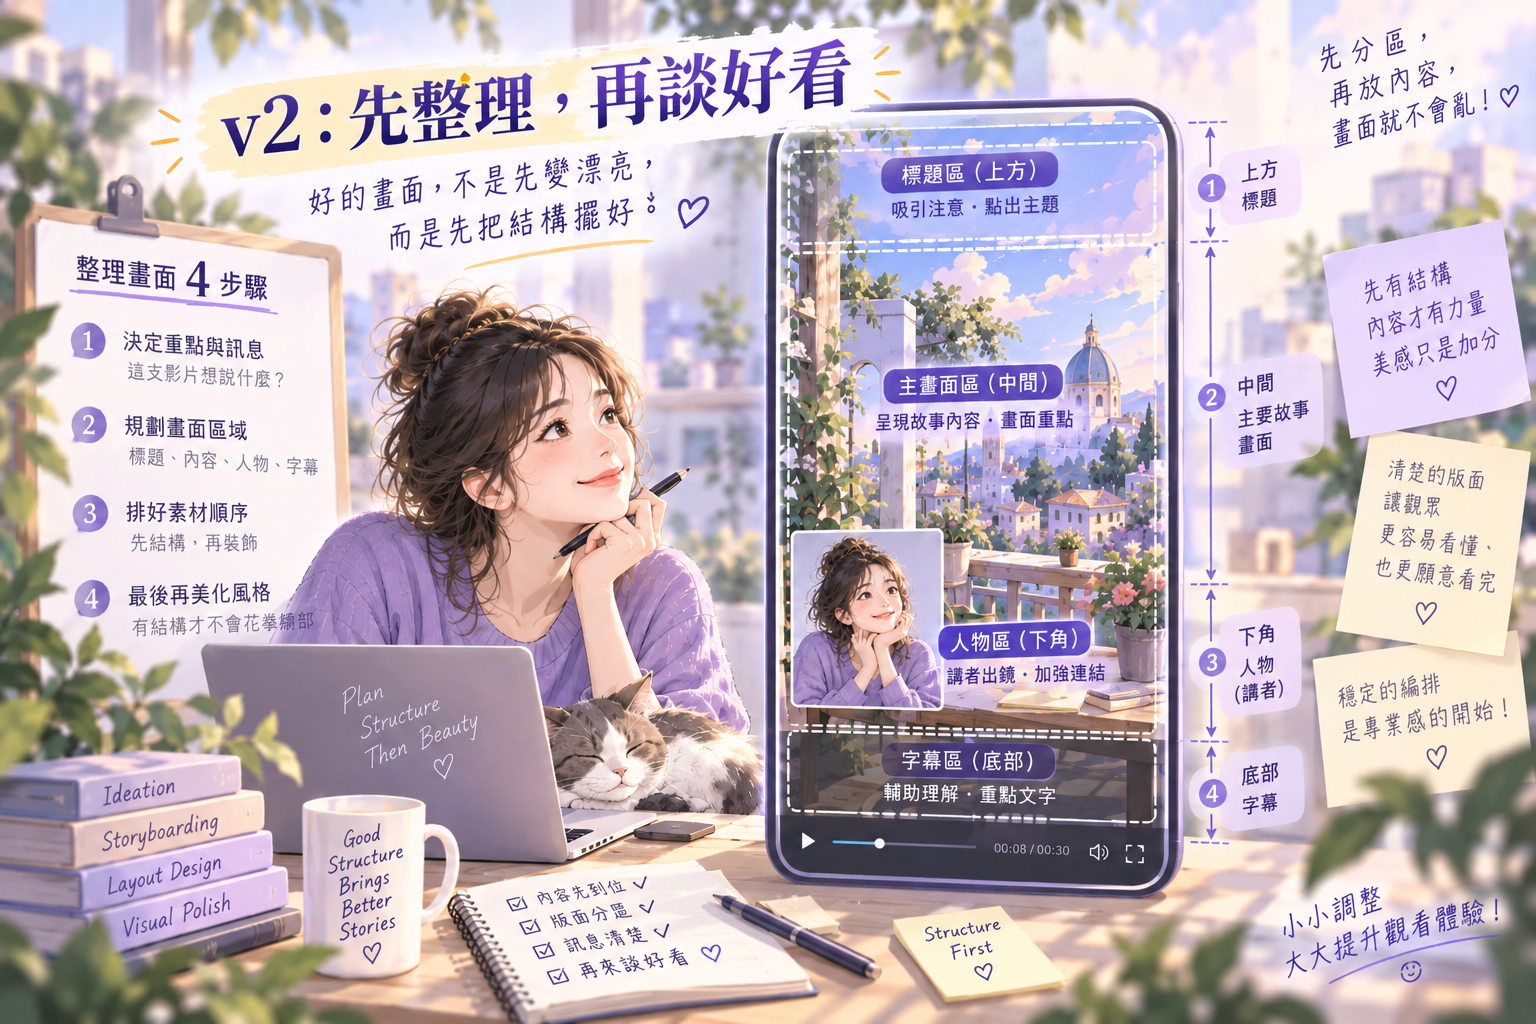
因此 v2 我沒有立刻要求:更多動畫、更多特效、更多素材,反而先處理最基本的觀看問題。
例如:
-
- 字幕往下移
- 主要知識區與字幕區分開
- 減少互相打架的元素
- 重新整理文字大小
- 避免所有重點同時出現在畫面
這一版給我的感覺就比較像:先把房間整理乾淨!家具不一定換,但是把不該擋路的東西先搬掉。
這一步讓我開始理解 Safe Zone
以前我做影片,大多只注意:文字有沒有超出畫面。
後來才慢慢開始把畫面分成不同安全區域。
| 區域 | 主要用途 |
|---|---|
| 上方 | 品牌、標題、必要的 Hook |
| 中央 | 主要 Story Scene、插畫、知識內容 |
| 左下/右下 | Presenter 或輔助元素 |
| 最底部 | 字幕 |
一旦安全區先分好,後面的動畫就比較不會一直撞來撞去。
但 v2 還是沒有解決最核心的問題:畫面仍然太像資訊卡
字幕整理乾淨之後,確實比較舒服。可是我還是覺得:不吸睛。
這時候我開始知道問題已經不是排版。而是視覺內容本身太單調。
一段口播如果只有:一句標題、一張卡、三個重點,就算排得非常漂亮,仍然很容易像簡報。
所以我開始往 v3 走。
v3:開始加入真正的「畫面」,而不是只加入更多 UI
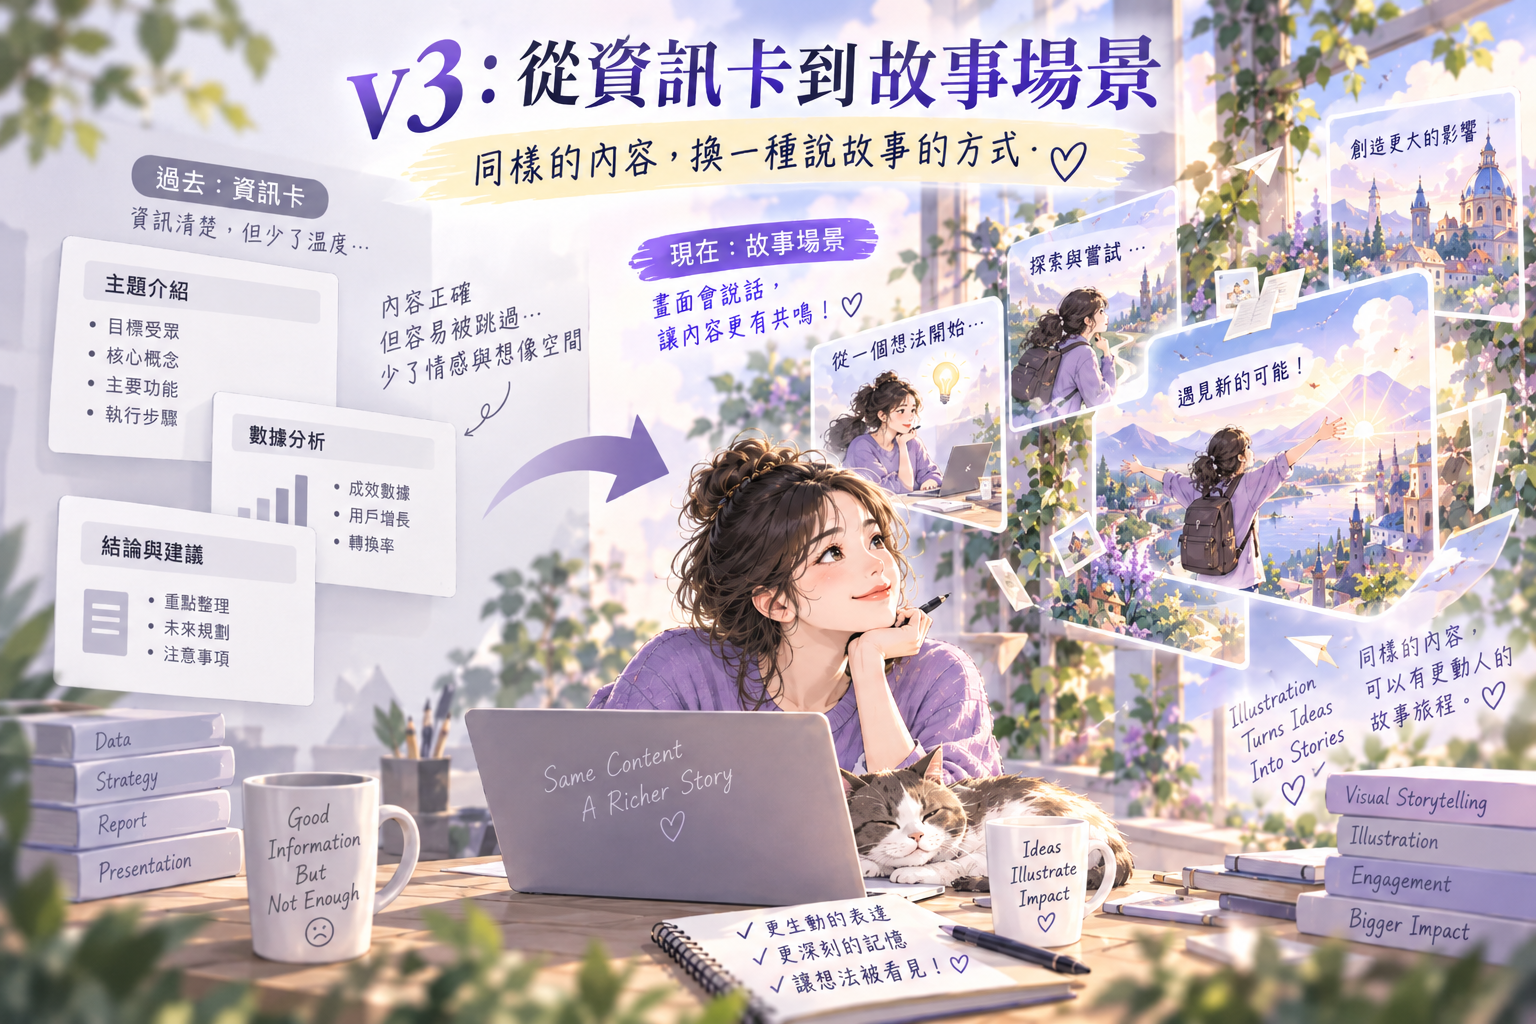
這是一個很大的轉折。
以前我看到畫面太空,直覺是:多一張卡、多一個 Icon、多一段文字。
到了 v3,我開始改成:「這一段如果用一個場景來表達,會長什麼樣子?」
例如口播講工作被打斷,以前可能寫:訊息、會議、通知。
現在則變成:一個人在桌前工作,旁邊的通知慢慢增加,手機亮起、行事曆跳出,桌上的工作越堆越多,這時畫面才開始真的和口播一起說話。
這也就是我開始進入 Illustrated Storytelling 的地方
從 v3 開始,我比較不再要求:「這裡放三個 Bullet。」
而會要求:這裡發生一件事情。
所以我的思考從:文字 → 排版 → 動畫
慢慢變成:口播 → Visual Event → Story Frame → Motion 這個改變非常大。
但是 v3 又出現新的問題:插畫很好看,可是動不起來
這就是第 19 篇的問題。AI 很快可以生出一張很漂亮的 Story Frame。
人物、桌子、窗戶、手機、文件、光線、全部都有,可是全部黏在同一張圖片裡。
所以動畫還是只能:Zoom、Pan、淡入、淡出,這就是我從 v3 繼續走向 v4 的原因。
v4:不再只動「圖片」,開始動「Layer」
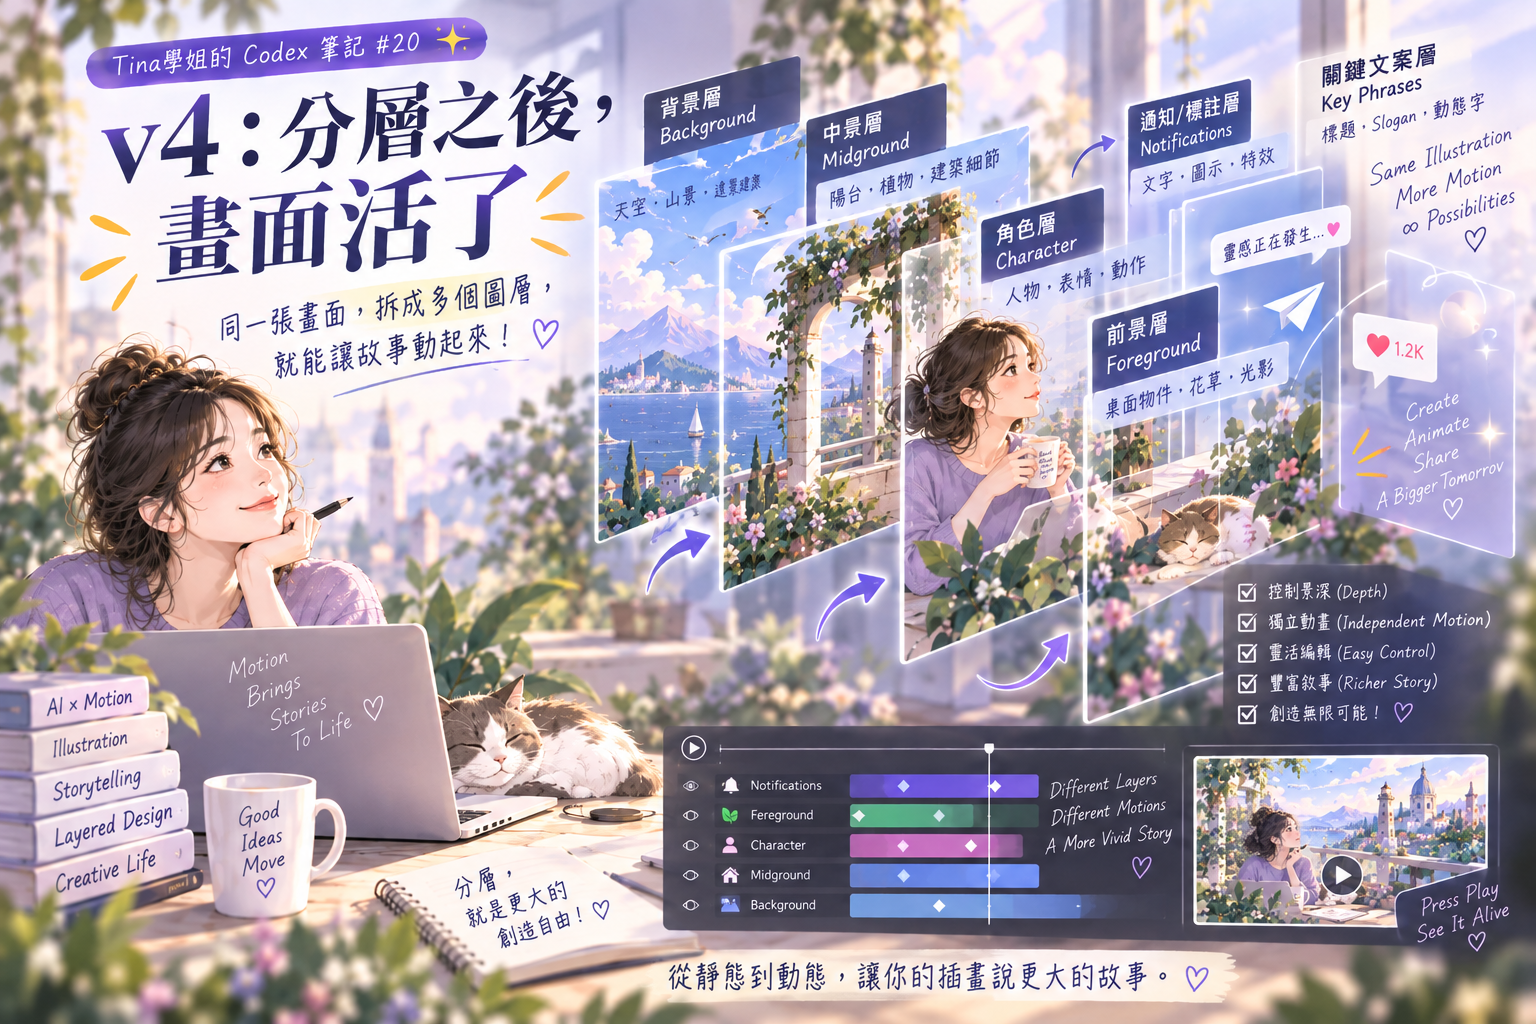
到了 v4,我開始把 Story Frame 拆開。
背景、人物、前景、物件、文字、特效,開始變成獨立 Layer。
這時動畫突然有了完全不同的可能性。
背景可以慢慢推、人物可以微微靠近、通知可以單獨跳出、前景葉子可以比背景移動更快,Key Phrase 可以最後才出現。
畫面開始產生:前後景、節奏、焦點、時間順序。
v4 最重要的改變,不是「動畫變多」
而是:動畫終於開始有任務。
例如通知跳出,不是因為:「這裡空空的,讓它動一下。」
而是因為口播正在說:「我們不停被各種訊息打斷。」
所以通知真的一個一個進來。
這種 Motion 是:Story Motion,而不是 Decorative Motion。
這時我也開始減少不必要的動畫
很有趣。
前面一直覺得:影片不夠好看,是動畫太少。
到了 v4 反而開始:刪動畫。
因為 Layer 越多,就越需要控制。
不是所有東西都要晃、不是每一個字都要彈、不是每一張圖都要飛。
有些 Layer 最重要的工作,就是:安靜待著。讓真正重要的 Motion 更清楚。
那為什麼做到 v4,最後還多了一個 v4.1?
因為 v4 已經不是「重做方向」了。大方向基本成立。
接下來剩下的,是一些觀看上的小問題。
例如字幕:某些句子一長,就會一次出現兩行;技術上沒錯,但看起來會變成一整塊文字突然壓上來。
所以後來我又想:字幕能不能不要兩行一起出現,而是跟著口播一句一句出現?
這類修改,我現在就會理解成:v4.1。
v4.1:不再改大架構,而是修觀看感受
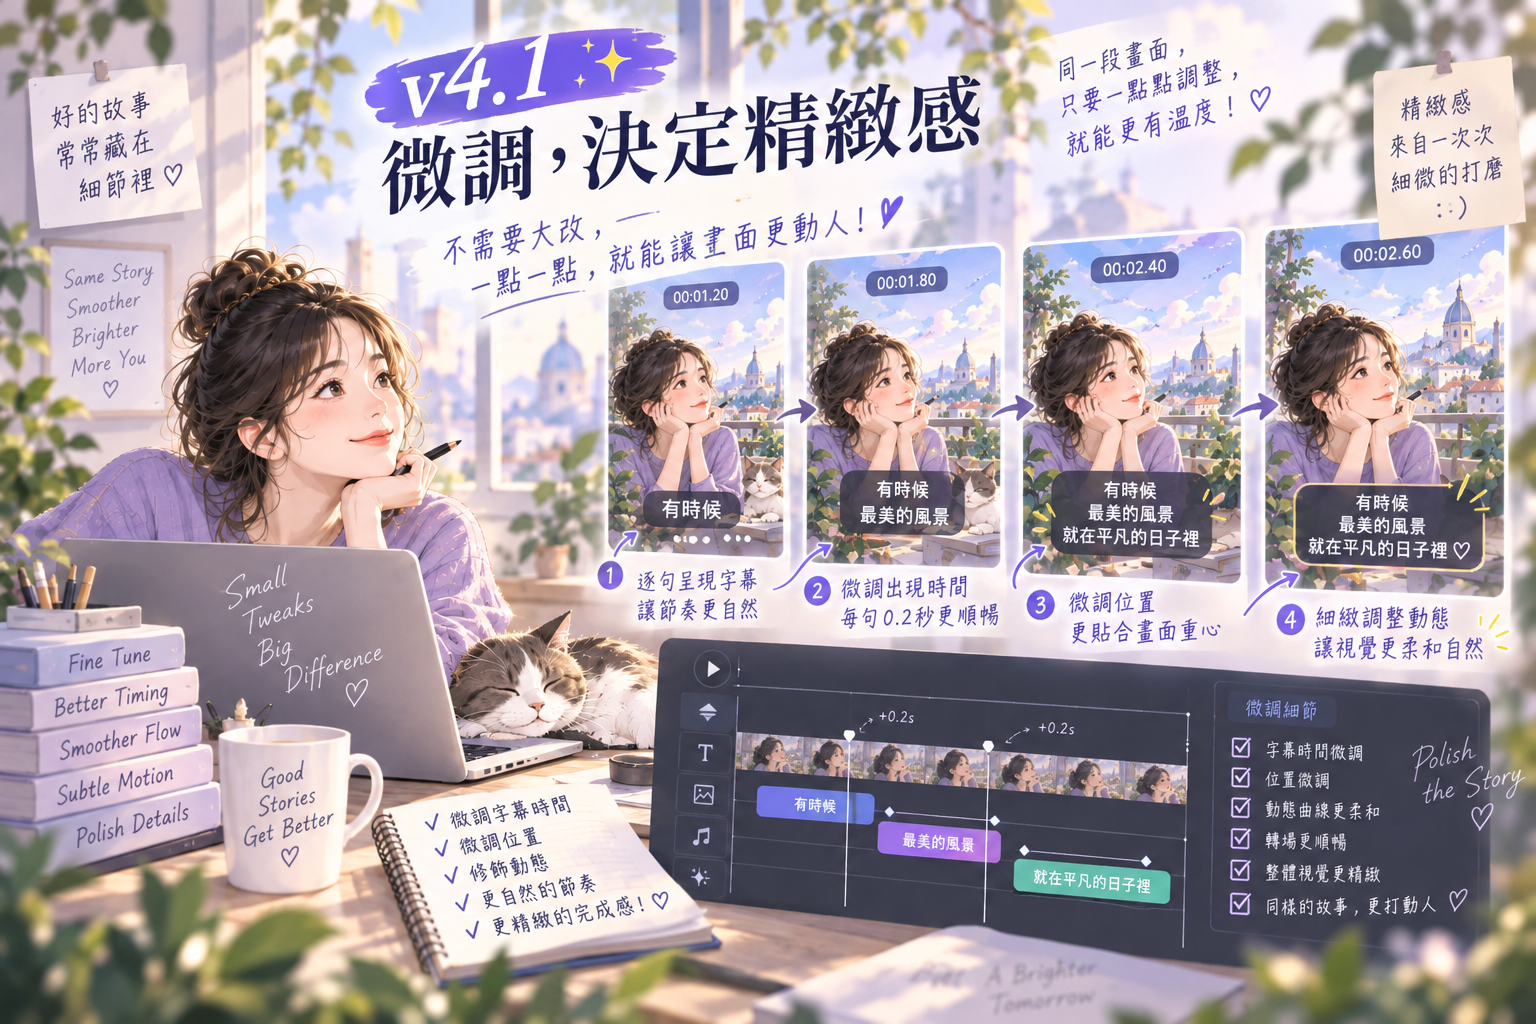
到了這個階段,我不希望再把整支影片推倒。
而是只修:字幕分句、字幕出現時間、位置再往下幾個像素。
某個動畫快 0.2 秒、某張圖再大一點、某個前景不要擋住人物、某個 Key Phrase 晚一點出現。
這些全部都是:Micro Refinement,也就是微調。
這也是我第一次真正理解版本號的小數點
以前我對:v1 → v2 → v3,其實沒有很嚴謹的概念。
現在我反而覺得可以這樣理解:
| 版本變化 | 代表意思 |
|---|---|
| v1 → v2 | 結構或方向有明顯修改 |
| v2 → v3 | 視覺方法明顯改變 |
| v3 → v4 | 動畫系統、素材結構明顯升級 |
| v4 → v4.1 | 方向不變,只修細節與體驗 |
這樣未來看到檔名,我自己也比較知道:這一版到底發生多大的改變。
如果把整個 v1 → v4.1 濃縮成一張表
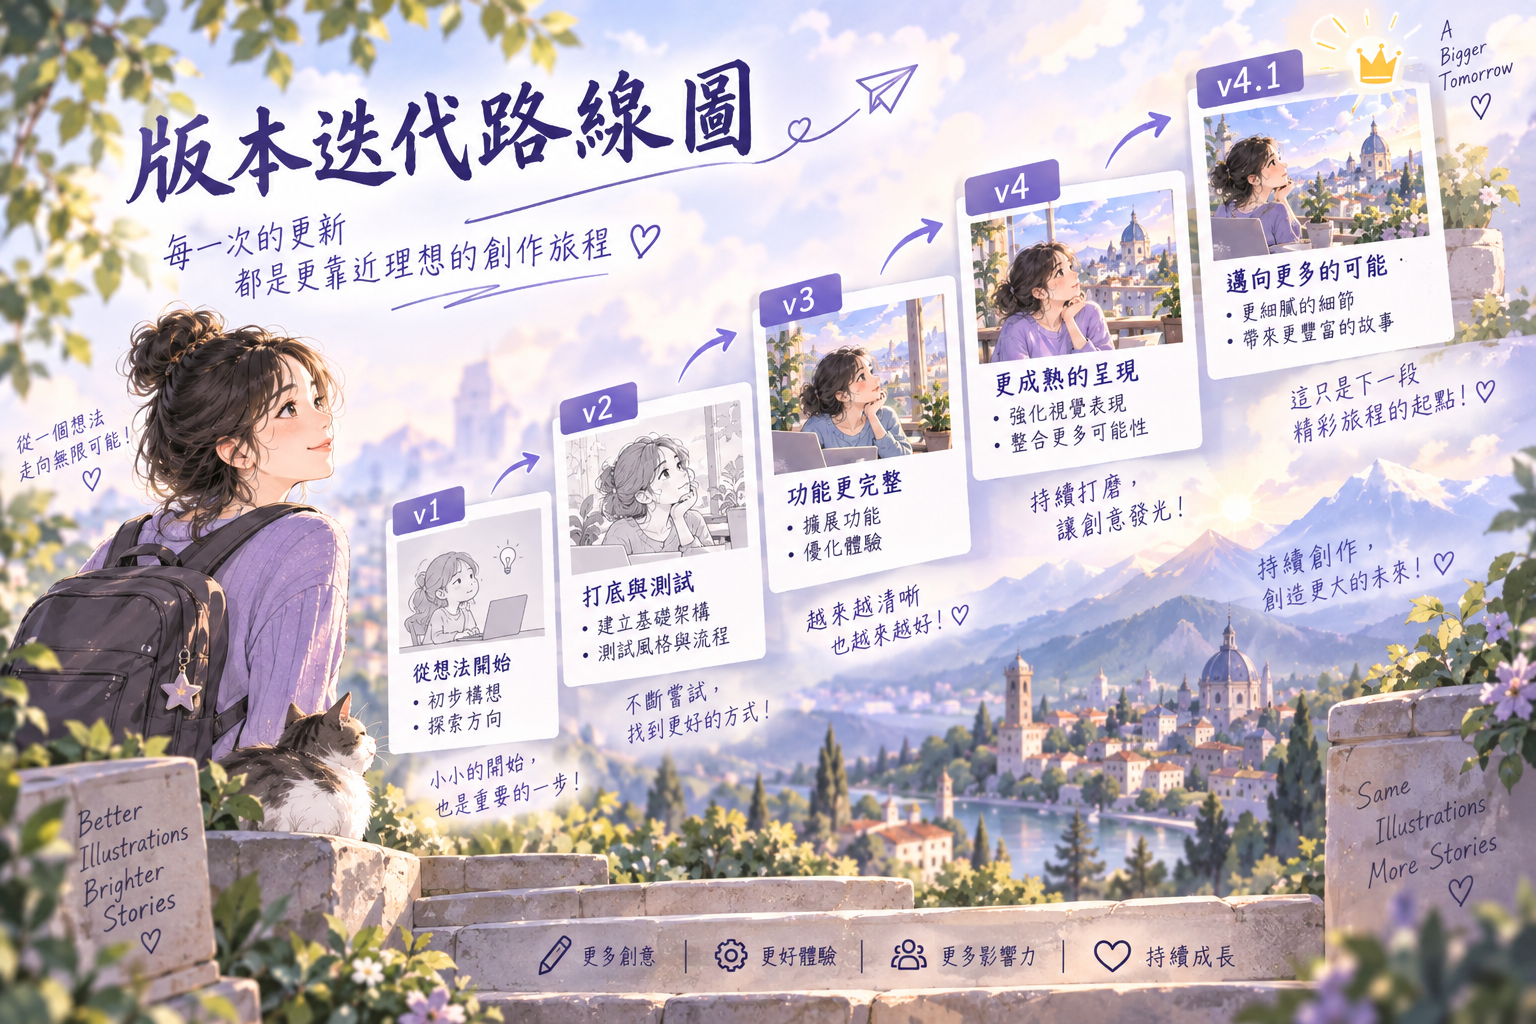
| 版本 | 主要問題 | 主要修改 |
|---|---|---|
| v1 | 功能完整,但像會動的 PPT | 確認第一版流程能跑通 |
| v2 | 字幕太高、版面擁擠、資訊互搶 | 重新整理 Safe Zone、字級與字幕位置 |
| v3 | 排版改善,但視覺仍偏資訊卡 | 加入 Illustrated Storytelling、Visual Event、Story Frame |
| v4 | Story Frame 好看,但單張圖動畫有限 | 拆 Layer、加入 Parallax、Story Motion、前後景 |
| v4.1 | 大方向已成立,只剩觀看細節 | 字幕分句、時間、位置、Motion 節奏等局部微調 |
從這五個版本,我反而發現「不要一次改太多」很重要
假設我 v1 覺得很難看。
然後下一句就跟 Codex 說:「全部重做,字幕、字體、背景、插畫、動畫、人物、轉場全部換。」
最後可能得到一個完全不同的 v2。
可是我根本不知道:到底哪一個修改有效?哪一個反而讓它更糟?
所以後來我比較喜歡:一次解決一個主要問題。
例如:這輪只修字幕、下一輪只修 Scene、下一輪再修 Motion,這樣每一次迭代比較有意義。
我現在會先分清楚:這是「結構問題」還是「細節問題」
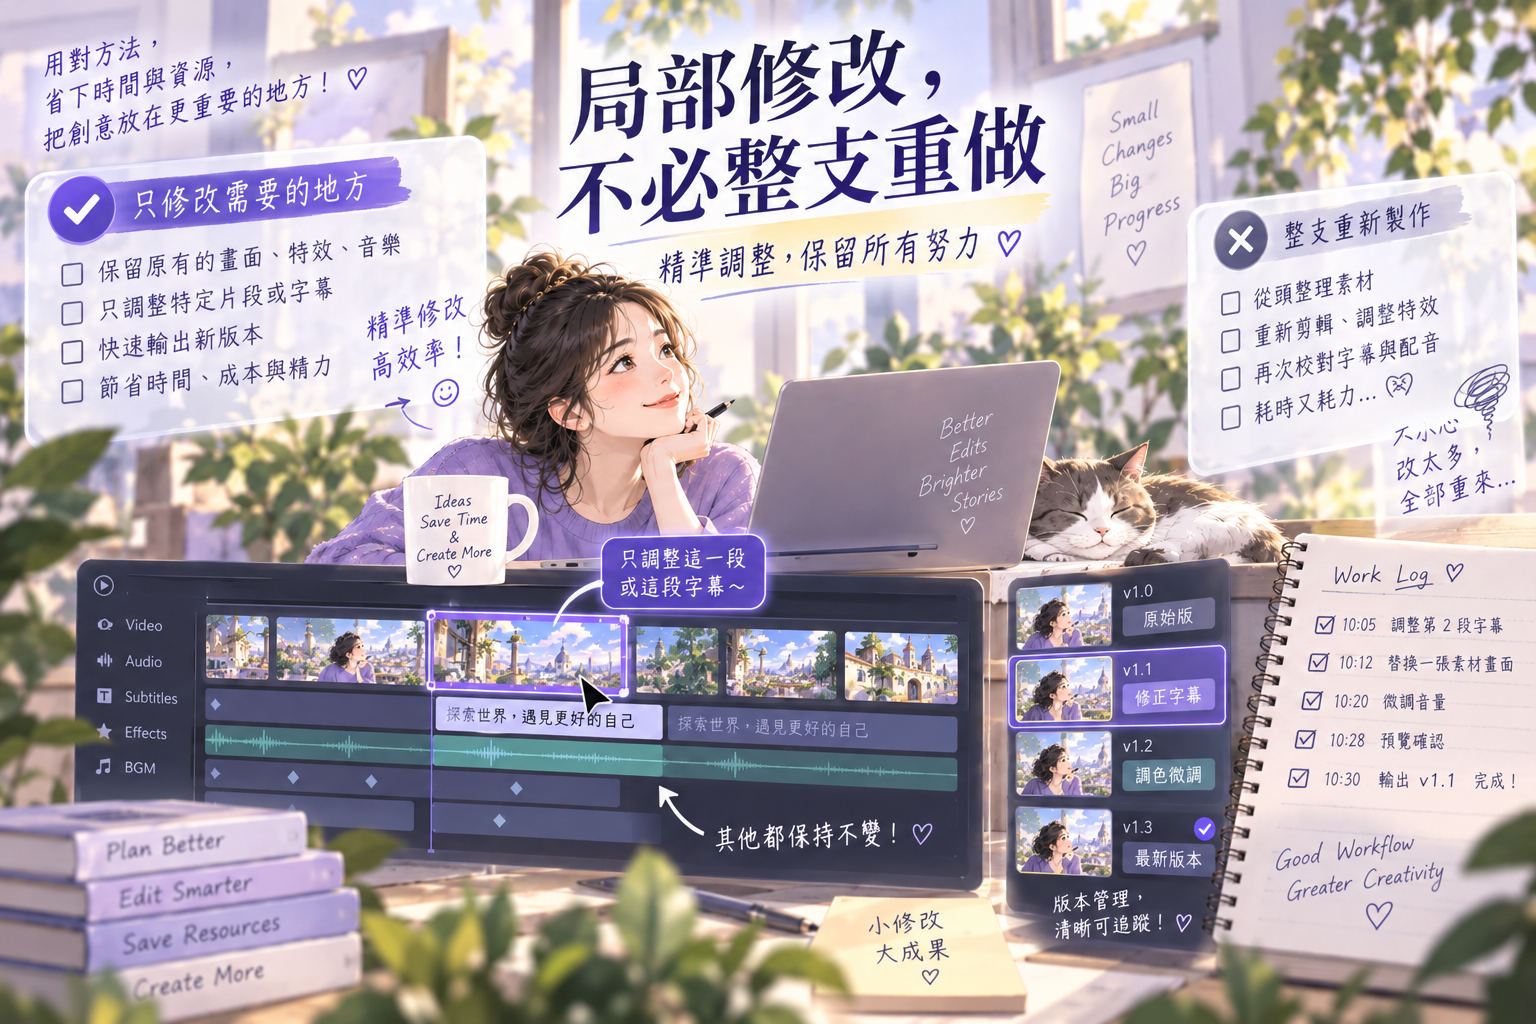
這會直接影響我要不要重做。
結構問題
例如:整支仍然像 PPT、Story Scene 不成立、畫面根本沒有主次。
素材本身選錯。
這種問題只移字幕 10px 沒用,它需要重新設計 Scene。
細節問題
例如:字幕高了一點、某句分段不好、動畫慢 0.3 秒、圖片小了一點、Presenter 擋到一個字。
這種東西就完全不需要:整支重做。
這個判斷,其實會直接影響 Codex 額度
如果每發現一個小問題,就叫 AI:重新分析、重新改整套程式、重新產所有素材、重新 Render 全片,不只慢,額度也會消耗得非常快。
所以做到 v4.1 之後,我反而開始更在意:能不能只改出問題的那一塊?
而不是:能不能再重新做一支?
這也是我後來開始建立「局部修改」思維的原因
例如問題只出在字幕,那就改字幕規則。
問題只在 Scene 2,就只改 Scene 2。
問題只在 Presenter,就只處理 Presenter Layer。
問題只在圖片,只替換那張 Asset。
這樣整个工作流才有可能真的大量化。
AI影片真正的成本,不只是 Render 時間
還有:模型額度、生圖額度、第三方工具額度。
數字人生成時間、HyperFrames Render、自己的檢查時間。
所以如果每一次「修一個字」都等於「整支重做」,這套 Workflow 根本無法規模化。
我現在會把修改分成四個等級
| 修改等級 | 範例 | 處理方式 |
|---|---|---|
| Level A:文字 | 字幕、Key Phrase、錯字 | 只改文字 Layer |
| Level B:版面 | 位置、尺寸、Safe Zone | 只改 CSS/Layout |
| Level C:Scene | 一個場景不好看 | 只重做該 Scene |
| Level D:結構 | 整個視覺方法錯誤 | 才考慮升大版本重構 |
我覺得這張表對之後大量做影片會非常重要。
Preview 也開始比 Final Render 更重要
如果每一個微調都直接輸出最終高品質 MP4,等待時間會非常長。
所以我現在比較喜歡:修改 → Preview → 確認 → 再改。
直到大方向完全確定,才:Final Render。這和前面做銷售頁其實是一樣的。
網站也不是每改一個 Padding,就重新打包 ZIP 上正式站。
影片也沒有必要每改一個字幕,就完整輸出一次最終檔。
我現在的影片迭代流程,大概會變成這樣
v1 → 先看結構能不能跑 → 列出問題

v2 → 先修版面/字幕 → 確認觀看安全區

v3 → 改善 Storytelling → 增加 Visual Event

v4 → Layered Motion → 改善景深、焦點與節奏

v4.1 → 微調字幕、Timing、Position → Preview QA → Final Render
每一版最好都留下「修改紀錄」
這也是我後來覺得非常重要的一件事。
不然做到 v4 時,很容易忘記:v2 到底修過什麼?這個字幕規則是什麼時候決定的?為什麼 Presenter 不放正中央?
所以可以有一個很簡單的:CHANGELOG.md
裡面寫:
v1
- 初版流程完成
- 字幕偏高
- 畫面 PPT 感過重

v2
- 字幕移至底部安全區
- 重整版面與文字層級

v3
- 加入 Story Frame
- 減少純卡片式畫面

v4
- 導入 Layered Motion
- 加入 Parallax 與 Story Motion

v4.1
- 字幕一句一句出現
- 微調字幕位置
- 修正部分動畫 Timing
這樣未來重新打開專案,一眼就知道:這支影片是怎麼長成今天這個樣子的。
這些版本不是失敗,它們其實都是「測試資料」
以前看到 v1 不好看,我會覺得:失敗、浪費時間。
現在反而會覺得:
-
- 沒有 v1,我就不知道字幕太高。
- 沒有 v2,我不會知道排版整理好之後,真正缺的是 Storytelling。
- 沒有 v3,我也不會發現漂亮插畫還是動不起來。
- 沒有 v4,我就不會知道最後真正需要修的其實只是小細節。
所以每一版都不是:「前一版做錯了。」
而是:「前一版告訴我下一個問題在哪裡。」
這也是 AI 工作最容易被忽略的一點:看懂問題,比重新生成更重要
如果我只會:不好看 → 再生成、不好看 → 再生成、不好看 → 再生成,最後很可能只是一直抽卡。
真正比較有用的是:不好看?為什麼?是字幕?是構圖?是 Story?是 Layer?是 Timing?
把原因找到之後,再改對應的位置。
我現在會用這五個問題看每一版
| 問題 | 我要看的事情 |
|---|---|
| 1. 第一秒看得懂嗎? | Hook 與視覺焦點清不清楚 |
| 2. 關掉聲音還看得懂嗎? | Story Scene 是否真的參與敘事 |
| 3. 字幕好不好讀? | 位置、分句、速度與 Safe Zone |
| 4. 動畫有沒有任務? | 是不是只是為動而動 |
| 5. 哪一個地方讓我想快轉? | 節奏、重複或資訊過載 |
什麼時候才算「可以停止修改」?
這也是一個很危險的問題。
因為影片永遠可以再修:字可以再大 2px、動畫可以再快 0.1 秒、圖片可以再換一張,如果一直追求完美,永遠不會完成。
所以我現在反而會替自己設一條線。
至少做到:
-
- 內容正確
- 字幕正常
- 畫面沒有明顯衝突
- Story 看得懂
- Motion 不干擾內容
- 手機觀看舒服
- 沒有明顯技術錯誤
就可以先:FINAL。
而不是永遠停留在:「還可以再更漂亮一點。」
Tina學姐這次最大的體會:AI 不是一次把成品做出來,而是把修改速度變得很快
我現在覺得這可能才是 AI 工具真正厲害的地方。
不是:第一次就完美。而是:
-
- v1 不好,我指出字幕,它可以改。
- v2 還像 PPT,我改 Story,它可以改。
- v3 圖太扁,我拆 Layer,它還可以繼續改。
以前如果每一次都是人工重新剪、重新排、重新輸出,這個反覆迭代成本會非常高。
現在 AI 真正幫我的,其實是:讓「再試一版」這件事情變得沒那麼可怕。
寫在最後:好的 AI 影片,不是生成出來的,是迭代出來的
從 v1 一路做到 v4.1,我自己最大的改變其實不是學會更多動畫。
而是開始知道:看到一支影片不好看時,不要急著全部推掉。
先找到問題。
再判斷它屬於:內容、版面、Scene、Motion、還是細節?然後只改應該改的那一層。
這和前面我做 Tina-Sales-Page-Generator 時學到的事情,其實完全一樣。
好的系統不是每次全部重來,而是知道哪一層可以被替換。
影片也是!
字幕可以換、Scene 可以換、圖片可以換、Motion 可以換、Presenter 也可以換!
但是整條 Workflow 不需要消失。
AI 影片真正變精緻的過程,不是一直重新生成,而是不斷把「問題」縮小到可以精準修改。
我覺得,這才是 v1 → v4.1 真正留下來的東西。