

上一篇第 20 篇,我整理了自己這支 AI 知識短片從 v1、v2、v3、v4,一路修到 v4.1 的過程。
做到後來,我開始發現一個很現實的問題。
不是影片不能再修。而是:每修一次,都要付出時間、運算與 Codex 額度。
尤其當我只是想改:一句字幕、一張圖片、一個 Scene、某個動畫快 0.2 秒,如果每一次都對 Codex 說:「整支重新做一次。」前面已經完成的逐字稿、Scene、圖片、動畫、Presenter、字幕,又全部重新跑。
這件事情做一支影片或許還感覺不大。但是如果未來要做10 支、30 支、100 支,這種做法一定撐不久。
所以做到第 21 篇,我現在對「AI 自動化」有一個很重要的新理解:真正成熟的自動化,不是每次都能重新做,而是不需要重新做的地方,就不要再做。
Codex 額度不夠,第一件事不是急著換模型
以前只要看到額度快到了,我第一個念頭很容易是:換比較省的模型?等額度恢復?是不是要加購?這些當然都是可能遇到的問題。
但做到影片工作流之後,我反而覺得應該先問另一件事情:「我現在做的工作,有多少其實是在重做已經完成的東西?」
如果一個專案每修一個小地方,就重新:讀所有檔案、分析全部內容、重寫整份程式、重新處理所有 Scene、重新 Render,那額度再多也很容易被吃掉。
所以額度問題,其實有一部分是 Workflow 問題
這件事我覺得非常重要,因為同一支影片可以有兩種做法。
做法 A:每次整支重做
發現字幕有問題 → 重新分析整支影片 → 重新修改所有檔案 → 重新跑所有 Scene → 重新 Render 全片
做法 B:只改字幕
發現字幕有問題 → 找到 Caption Layer → → 修改該句字幕 → Preview → 確認
 → 必要時只重新輸出
兩種方法得到的結果可能一樣,但中間浪費掉的工作完全不同。
第 20 篇的 v4.1,其實就是「省額度思維」的開始
到了 v4.1,我已經不再想:重新做一支 v5。
因為大方向沒有錯、Story Frame 沒錯、Layer 沒錯、動畫方向也沒錯,真正需要修的只是:字幕一句一句出現、位置再低一點、Timing 微調、少數 Motion 再順一點。
這時候如果整支重做,反而是一種:浪費。
我現在會先問:問題發生在哪一層?
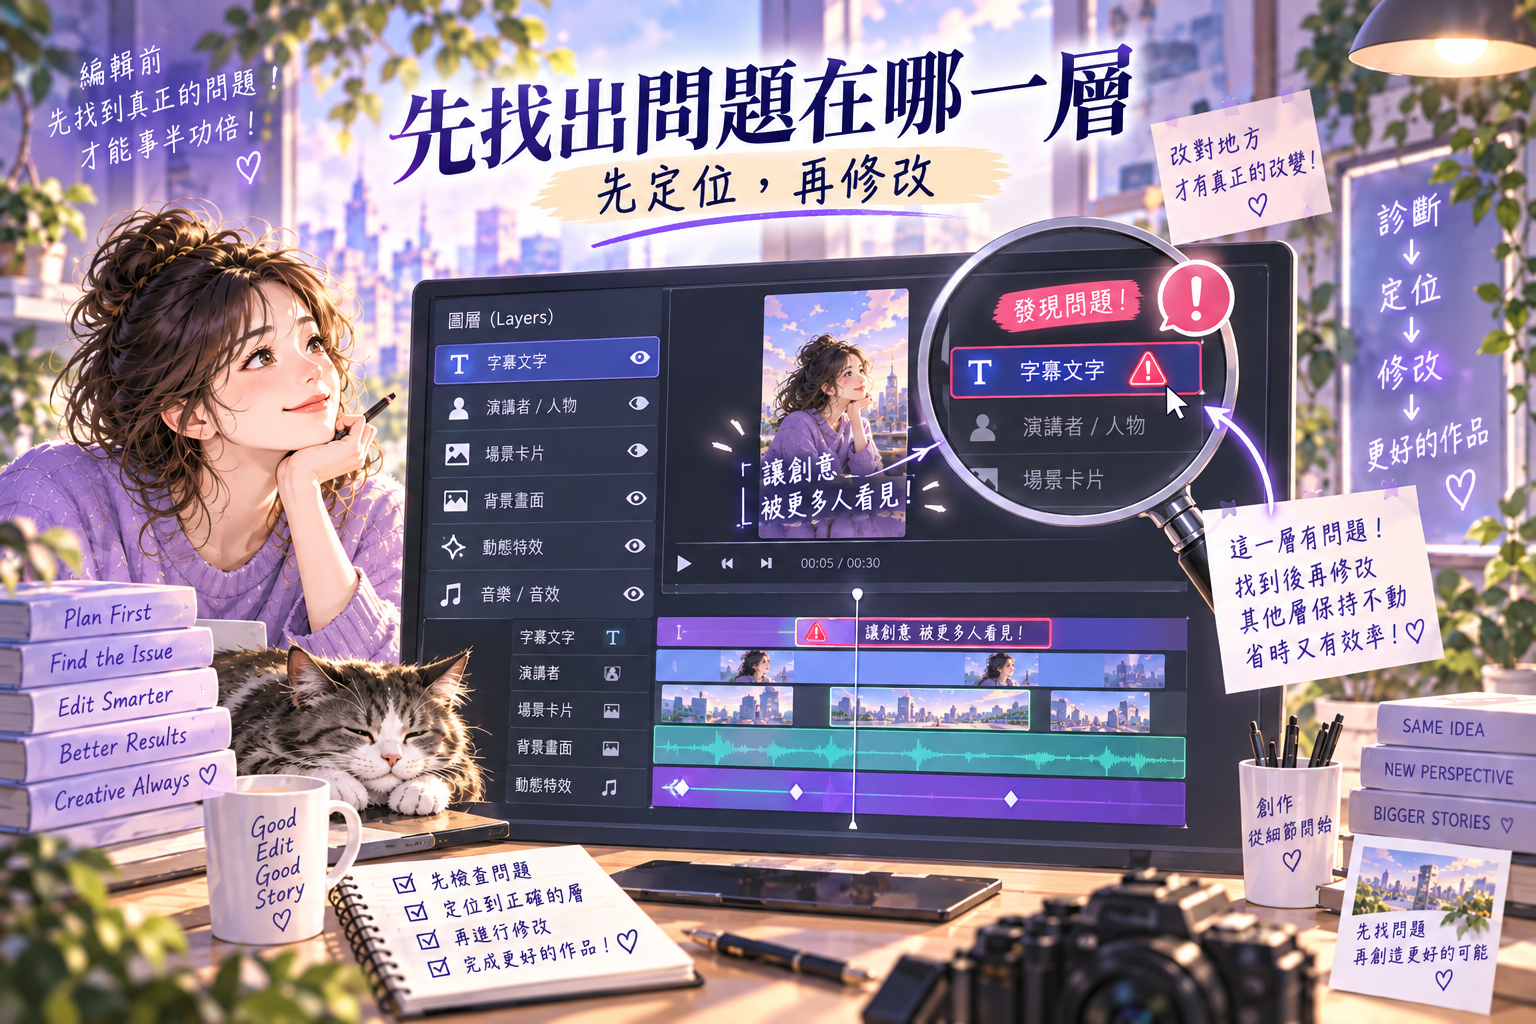
這個問題可以幫我決定到底要改多少。
| 問題 | 真正需要修改的地方 |
|---|---|
| 字幕錯字 | Caption / Text Layer |
| 字幕位置太高 | 字幕 Layout / CSS |
| 圖片不好看 | 單一 Asset |
| Presenter 太大 | Presenter Layer |
| Scene 2 不吸睛 | 只修改 Scene 2 |
| 整支還像 PPT | 才需要重新檢查整體 Visual Strategy |
也就是:先定位問題,再決定修改範圍。不要看到一個問題,就把整間房子拆掉。
我現在會把影片想成很多可以替換的零件
這和前面做 Tina-Sales-Page-Generator 的觀念其實完全一樣。
網站可以拆成:Brand DNA、Product DNA、Hero、Component、圖片、CTA。
影片也可以拆成:Audio、Transcript、Scene、Story Frame、Layer、Presenter、Caption、Motion、Render。
當它們全部黏成一團時,任何修改都很痛苦。
但如果本來就是模組化的:哪一個零件壞,就換哪一個零件。
第一個省額度方法:LOCK 已經確認的東西
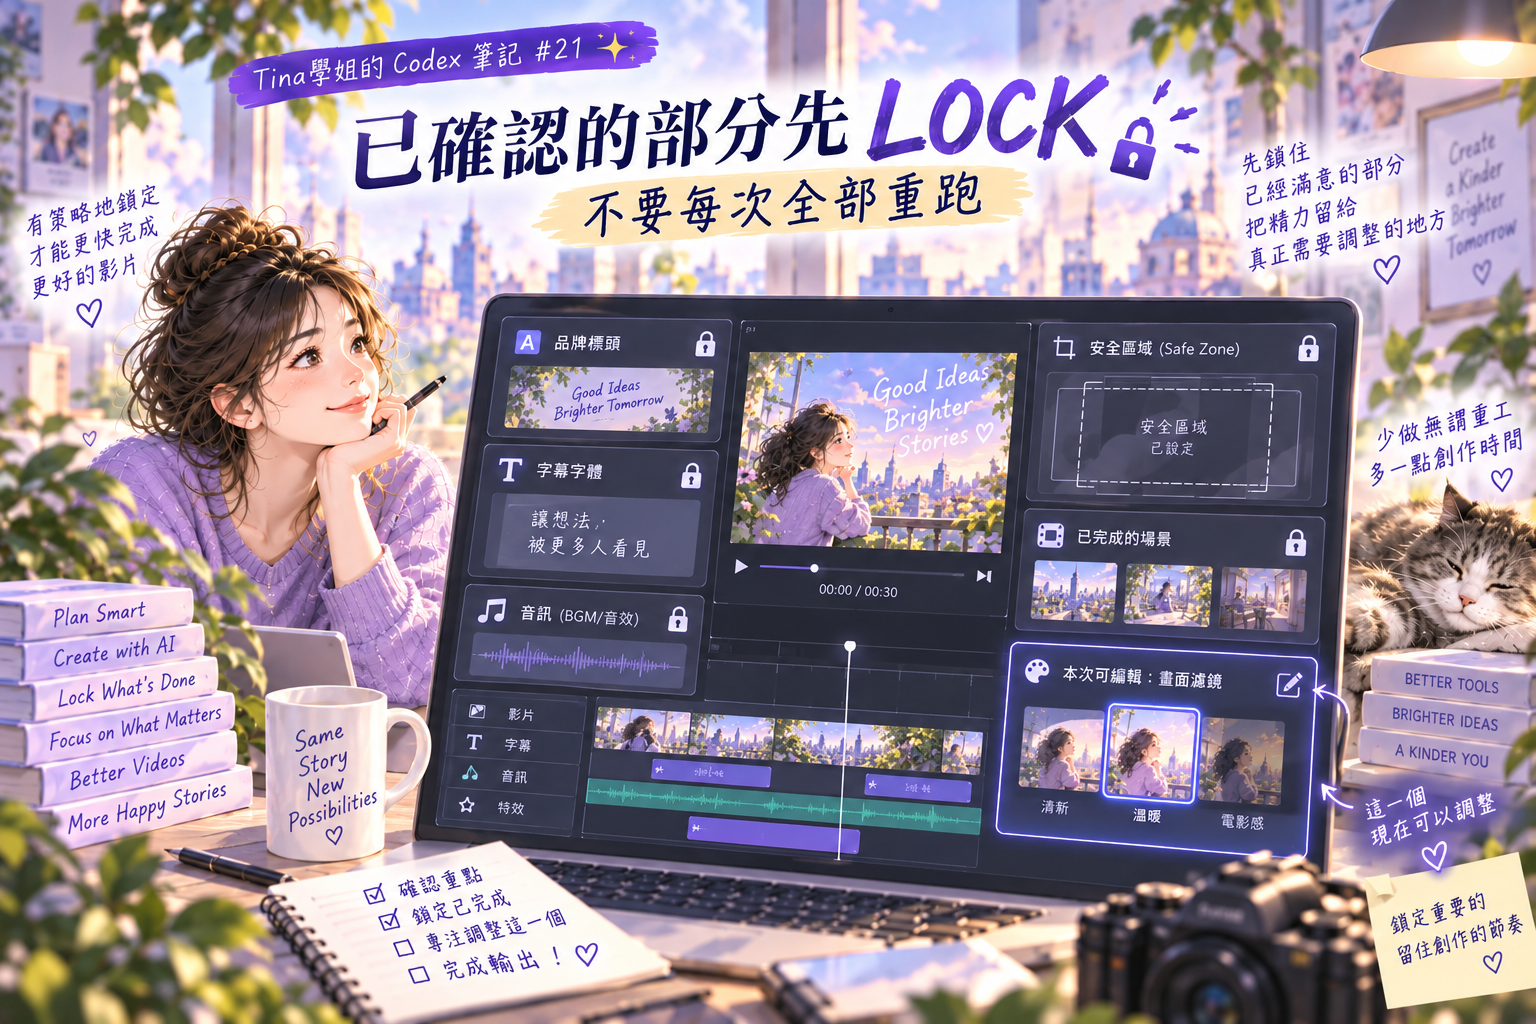
我覺得這個觀念可以直接從銷售頁搬過來。
例如影片做到 v4.1 時,某些東西其實已經不需要再討論。
像:
-
- 影片尺寸已經確定
- 字幕字體已經確定
- 字幕 Safe Zone 已經確定
- 原始錄音已經確定
- Scene 長度已經確定
- 品牌標頭已經確定
這些就可以視為:LOCKED。
下一次修改不要再請 Codex:重新決定字幕字體、重新設計畫布、重新規劃影片長度,因為那些已經不是問題。
越多東西被 LOCK,後面的修改範圍就越小
例如:
LOCKED:
- 1080 × 1920
- 15 sec
- audio.mp3
- subtitle font
- subtitle safe zone
- brand header
- Scene 01
- Scene 03

EDIT ONLY:
- Scene 02 image
這種指令比:「這支片第二段不好看,幫我改善。」清楚太多。
因為「幫我改善」很容易讓 AI 覺得:所有東西都可以動。
第二個方法:把修改分成不同等級
第 20 篇我已經開始用 Level A~D。
到了這一篇,我會更明確把它和資源消耗連起來。
| 修改級別 | 範例 | 原則 |
|---|---|---|
| Level A:文字 | 字幕、錯字、Key Phrase | 不要碰圖片與 Scene |
| Level B:版面 | 位置、大小、Safe Zone | 只改 CSS/Layout |
| Level C:素材 | 圖片、Presenter、單一 Overlay | 替換 Asset,不動其他內容 |
| Level D:Scene | 某段敘事方式錯誤 | 只重做該 Scene |
| Level E:Architecture | 整支策略錯誤 | 最後才考慮完整重構 |
真正需要整支重做的,應該是最後一種。
而不是最常用的一種。
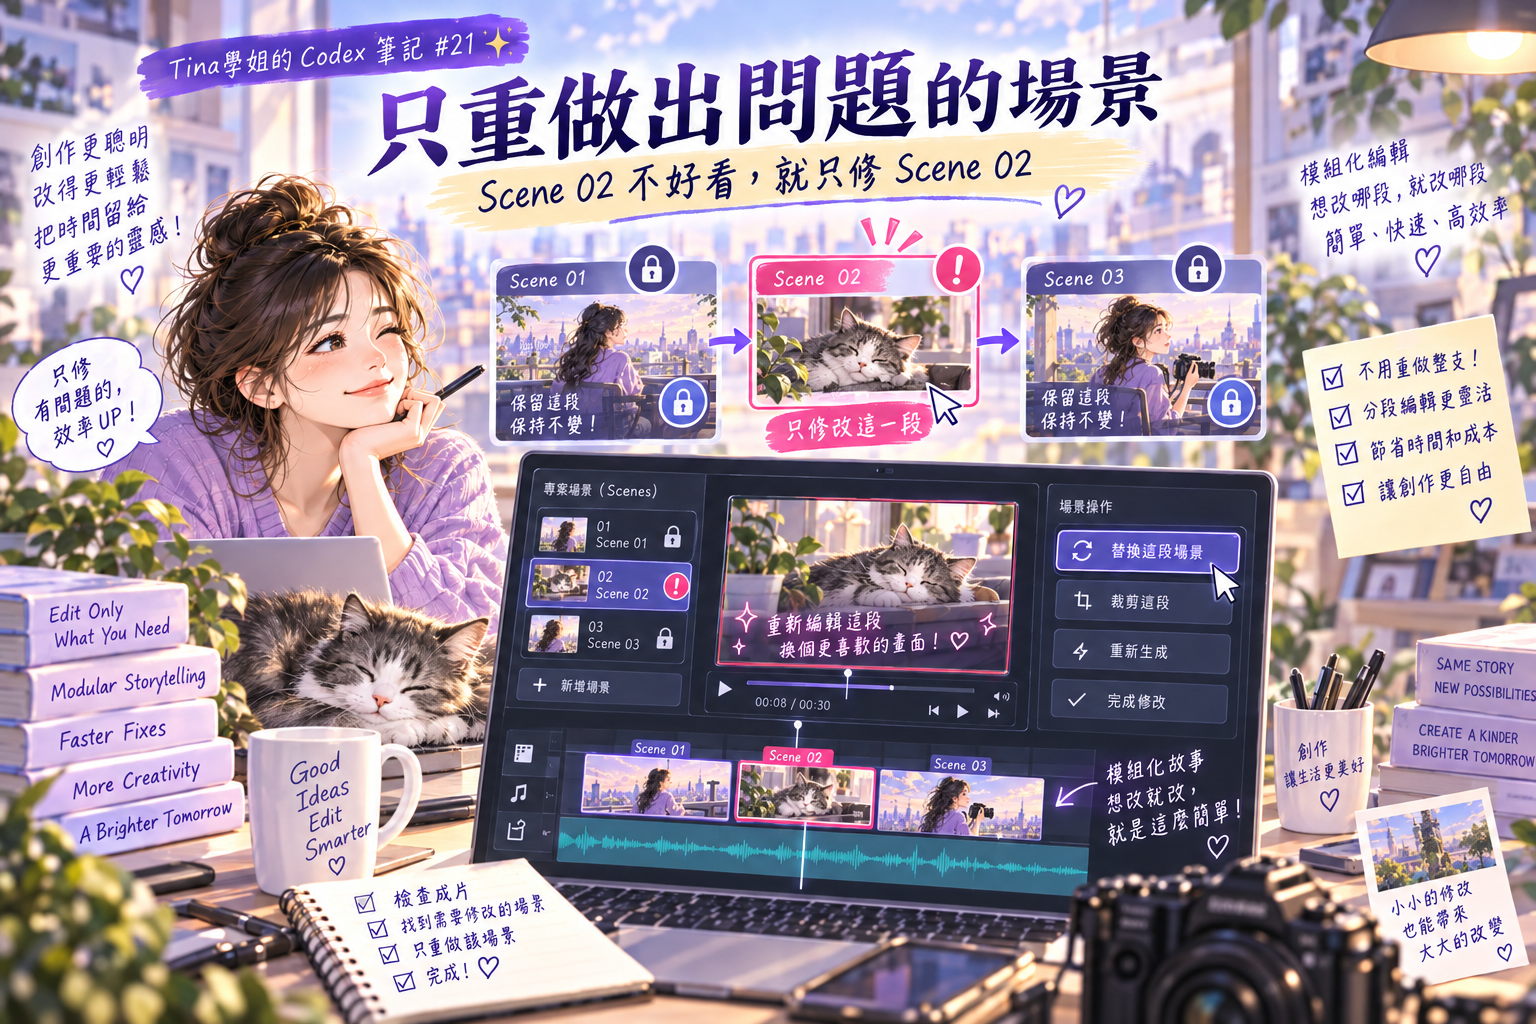
第三個方法:Scene 一定要能獨立
這對未來大量影片尤其重要。
假設一支 15 秒影片是:
Scene 01:0–5 sec
Scene 02:5–10 sec
Scene 03:10–15 sec
如果 Scene 02 不好看,我理想中的工作流應該是:
保留 Scene 01
保留 Scene 03
↓
只重做 Scene 02
↓
重新組合
而不是:
Scene 02 不好看
↓
三個 Scene 全部重新生成
這就是為什麼前面一直強調:資料夾、檔名、Scene、Layer,都要有清楚規則。
Scene 資料夾最好從一開始就分開
例如:
video-001/
├── audio/
│   └── voice.mp3
├── scene-01/
│   ├── bg.png
│   ├── character.png
│   └── scene.json
├── scene-02/
│   ├── bg.png
│   ├── phone.png
│   └── scene.json
├── scene-03/
│   ├── bg.png
│   └── cta.png
└── captions/
    └── captions.json
當結構本來就分開,後面 Codex 才比較容易知道:只碰 scene-02。
第四個方法:素材沒有壞,就不要重新生
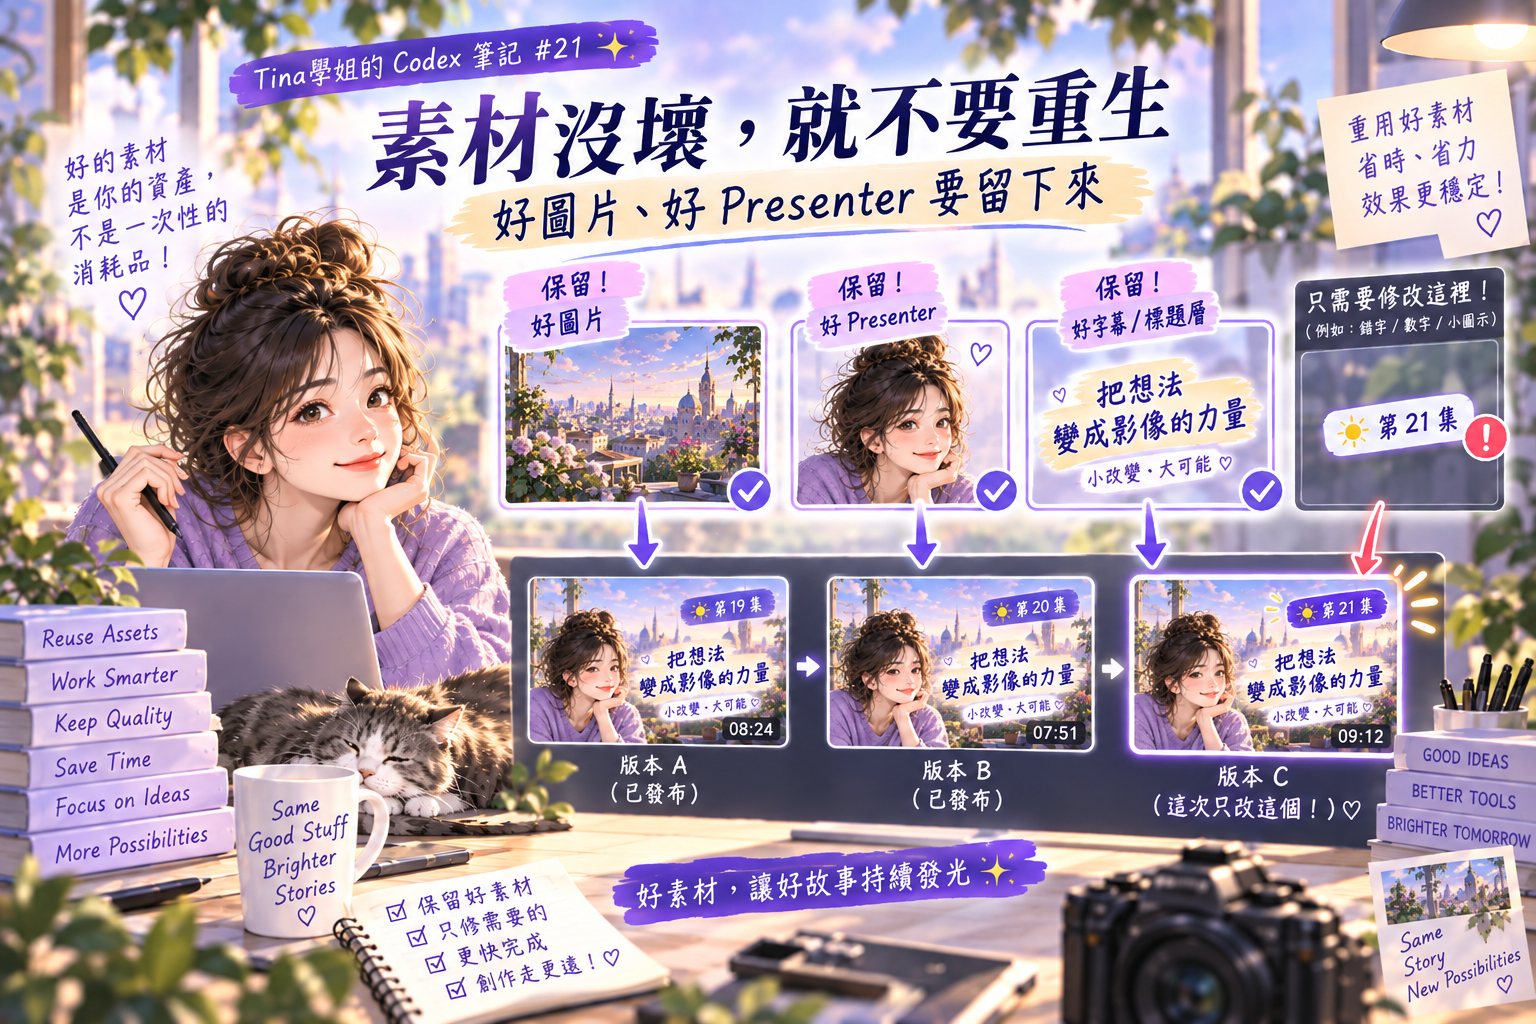
這件事情對 AI 圖尤其重要。
例如一張 Story Frame:人物很好、光線很好、構圖很好、只是字幕的位置不對,結果因為字幕要改,就重新生成整張 AI 圖。
下一張可能:人物臉變了、衣服變了、背景變了、風格也變了,原本沒有問題的東西全部又變成新問題。
所以我現在越來越喜歡:好素材先留下。問題不是素材,就不要碰素材。
這也是為什麼文字不要畫死在圖片裡
第 19 篇筆記已經提過,如果標題和字幕全部直接生在圖片裡:改一個字,就要重新生圖。
如果文字本來就是 HyperFrames 的獨立 Layer:
那只要修改:text: "新的文字"、圖片完全不用動。
這其實就是:為未來的修改預留空間。
第五個方法:不要每次都重新 Transcription
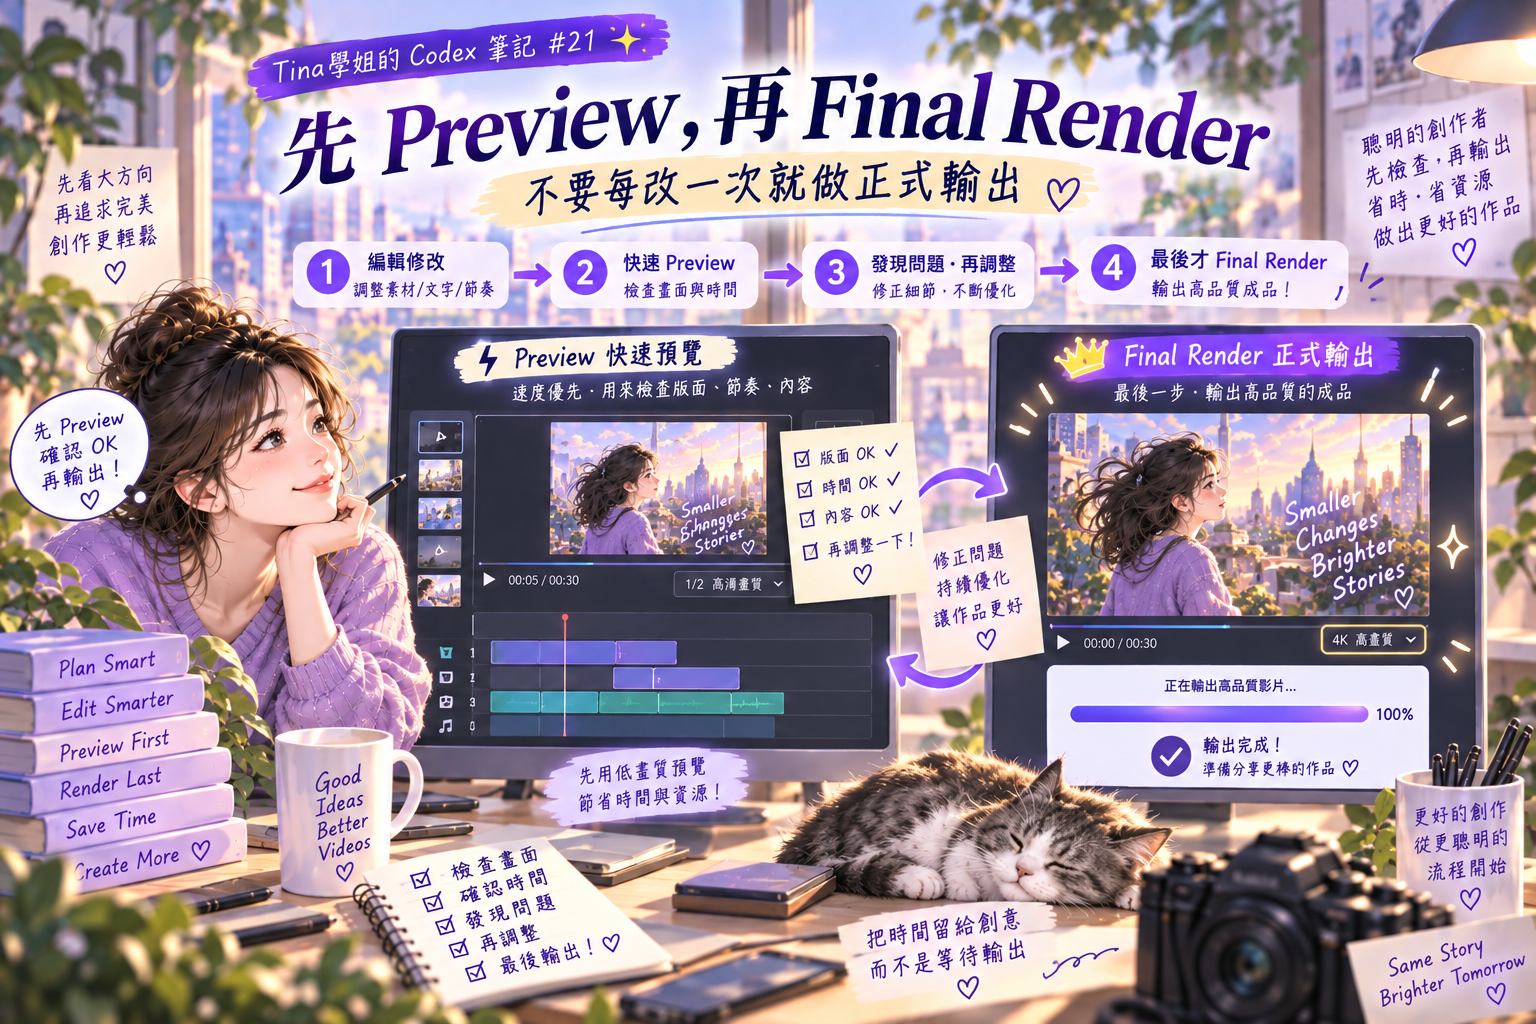
如果錄音完全沒有換、逐字稿也已經確認、字幕時間軸也沒有問題。
那後面只是:換圖片、修 Motion、調位置,其實沒有理由每次又把 audio.mp3 從頭重新辨識一次。
所以轉好的結果應該保存。
例如:
transcript.json
captions.json
timings.json
有需要才重新產。
這就是 Cache 思維
我現在會把它理解成:已經算過的答案,先保存。
只要輸入沒有變,就直接用。例如:
| 內容 | 何時才需要重新產生? |
|---|---|
| Transcript | 錄音改變 |
| Caption Timing | 錄音或分句改變 |
| Story Frame | Scene 視覺策略改變 |
| Presenter | 講師或語音改變 |
| Motion | 動畫規則改變 |
不要因為其中一格改了,就五格全部重算。
第六個方法:Preview 和 Final Render 要分開
這也是非常實際的省資源方法。
我只是想看:字幕有沒有太高、圖片是不是太小、動畫是不是快了一點。
其實根本不需要:最高品質、完整輸出、正式版本。
這時只需要:Preview。等確認全部正確,再Final Render。
如果改五次,就做五次完整 Final Render,實在太浪費
比較合理的是:
修改 → Preview → 發現問題 → 修改 → Preview → 確認 → Final Render × 1
而不是:
修改 → Final Render → 修改 → Final Render → 修改 → Final Render
第七個方法:不要讓 Codex 每次重新讀整個專案
專案越做越大之後,檔案可能很多。
第 1 支影片、第 2 支影片、10 張圖、20 張圖、舊版、新版、Reference。
如果每次只是修 Scene 03,卻讓 Codex 又把整個世界讀一遍,就沒有必要。
所以工作指令越後期,越應該縮小 Scope。
例如不要說:請檢查這個影片專案並改善。
而是說:只修改 EP021 / Scene 02。
LOCK:
Scene 01
Scene 03
Audio
Captions
Presenter
Global style
只處理:
Scene 02 的背景圖片與兩個 Motion timing。
其他檔案不得修改。
這樣我自己也比較放心。
第八個方法:改之前,先叫 Codex 說「會改哪些檔案」
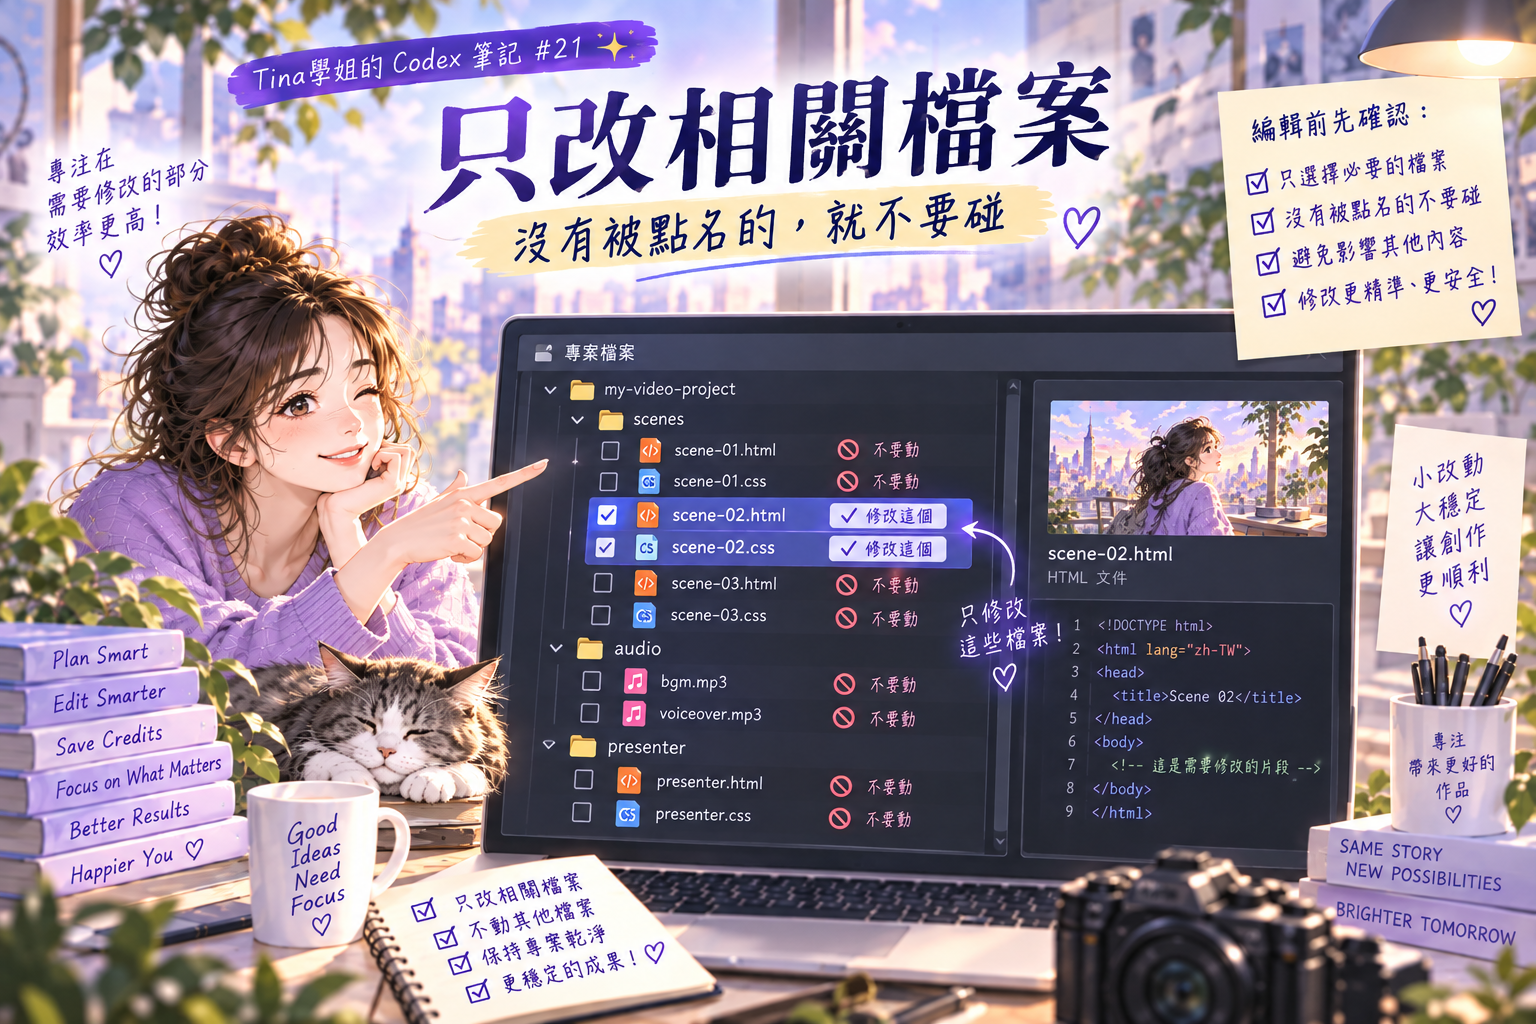
這是一個我覺得很實用的習慣,尤其專案已經很穩定時。
可以先要求:先不要修改。先告訴我這個問題需要改哪些檔案、哪些檔案不用碰。
如果它回答:
需要修改:
scene-02.html
scene-02.css

不需要修改:
audio.mp3
captions.json
scene-01
scene-03
presenter.mp4
我就知道這一次是:小手術。而不是全身重建。
這也可以避免「修 A 壞 B」
AI 修改專案最怕的事情之一就是:我只是叫它調字幕。
結果順手把:字體也換了、動畫也改了、圖片大小也改了、最後出現新的問題。
所以後期修改很重要的一句話是:Do not modify unrelated files or behavior.
也就是:沒有被點名的東西不要碰。
第九個方法:一定要保留版本,不要一直覆蓋
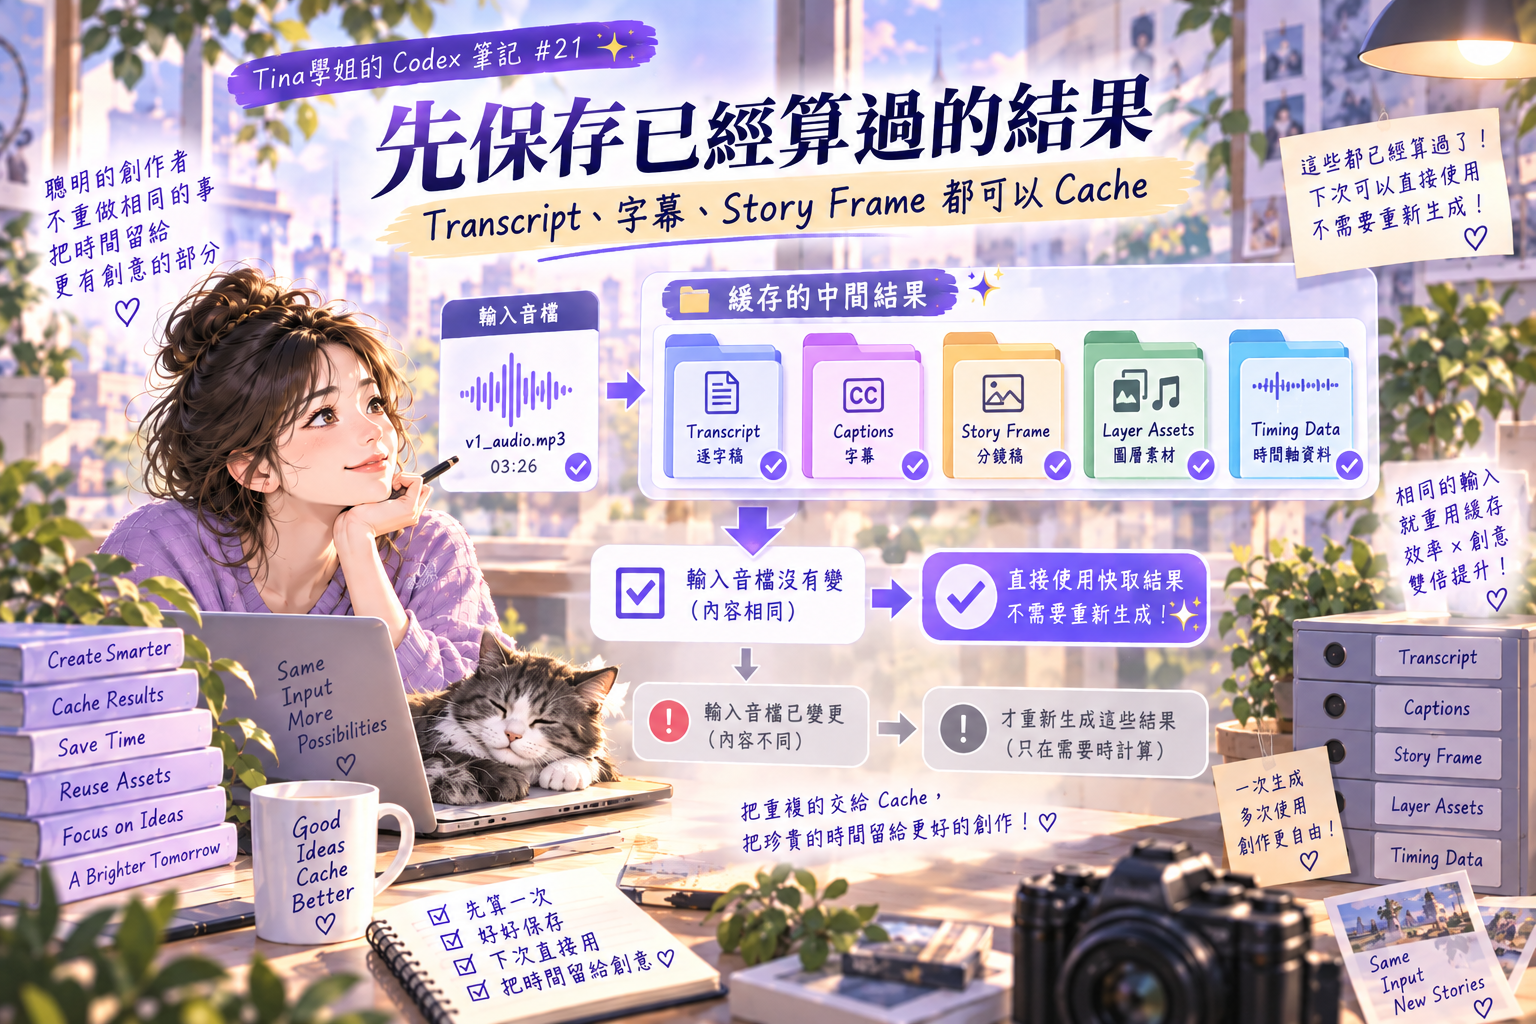
如果 v4 已經很好,我想試一個字幕新方式,結果把 v4 直接覆蓋,新版本反而不好看,這時就很麻煩。
所以我現在很認同:v4 → v4.1這種保留方式。
→ v4.2
至少上一個好版本還在。試錯才不會變成:「回不去了。」
CHANGELOG 也能減少重複思考
例如:
v4.0
- 導入 Layered Motion
- Scene 02 新增 notification layers

v4.1
- 字幕改為逐句出現
- subtitle Y position 下移
- Scene 02 timing -0.2s

LOCKED
- visual style
- audio
- presenter
- Scene 01
- Scene 03
下一次 Codex 進來,就比較容易理解:哪些是歷史決策。哪些還可以改。
第十個方法:最省額度的方法,有時候是「不要再修」
這聽起來很簡單,但其實很難。
因為影片永遠可以:再漂亮一點、字幕再順一點、圖片再換一張、動畫再細一點。
如果沒有停止條件,v4.1 可以一路變成:v4.2 → v4.3 → v4.4。
最後額度都花在:只有自己看得出來的 1% 差異。
所以我現在會設定「完成線」
至少:
-
- 內容沒有錯
- 字幕好讀
- 畫面看得懂
- 沒有明顯遮擋
- Motion 不干擾理解
- 音訊正常
- 手機觀看舒服
- 沒有技術錯誤
達到之後,就先FINAL!如果未來數據證明真的需要改善,再回來改。
不是每支影片都值得做到 v4.1
這也是我覺得非常重要的一件事。
有些影片只是測題材、有些只是短期活動、有些甚至不知道觀眾會不會看。
如果每支都做到:Illustrated Storytelling、Layered Motion、Presenter,v4.1 級精修。
工作量一定很大。
所以我現在反而會搭配第 19 篇的筆記:Motion Budget。
影片也可以有 Production Level
| 等級 | 使用情境 | 製作品質 |
|---|---|---|
| Level 1 | 大量測題 | 錄音+字幕+簡單素材 |
| Level 2 | 一般日常內容 | 基本 Story Scene+Motion |
| Level 3 | 重要知識影片 | Illustrated Storytelling+部分 Layer |
| Level 4 | 代表作/廣告/核心內容 | 完整 Layered Motion+Presenter+精修 |
這樣額度才會用在:真正值得精修的地方。
Codex 額度不是只能「省」,也要學會「分配」
我現在會覺得:完全不用額度當然不可能。AI 本來就是來幫忙工作的。
真正的目標不是:花得越少越好。
而是:不要把額度花在電腦已經做過的事情上。
需要 Codex 思考的地方,就讓它思考、需要重構的地方,就重構,但只是換一句字幕,就不要叫它重新當一次導演。
我現在心中的「省額度影片流程」大概是這樣
原始錄音 → Transcript(保存)→ Scene Plan(保存)→ Story Frame(保存)→ Layer Assets(保存)
→ HyperFrames Composition(保存)→ Preview → 找到問題 → 判斷問題所在 Layer → 只修改該 Layer / Scene
→ 再次 Preview → QA → Final Render
真正重要的是中間那一句:找到問題所在 Layer。
這句如果做得到,後面就不需要一直全部重來。
如果只改字幕,我希望未來甚至不需要重新問 Codex
這也是我真正想走到的下一階段,例如字幕規則已經確定、檔案格式也確定,那一些很單純的修改:錯字。
一句分成兩句、位置、字級,甚至可以由固定 Script 或 Skill 處理,不一定每一次都需要讓大模型重新思考。
這樣 Codex 可以留給:新的 Story、新的 Visual Strategy、複雜 Bug,真正需要推理的地方。
這就是 Automation 和 Agent 最大的差別之一
有些事情需要 AI 判斷。有些事情其實只是:規則。
例如:字幕固定離底部多少、字體用哪一個、輸出尺寸多少、檔名怎麼命名。
這些既然已經決定,就應該變成:程式規則。而不是每次又花推理額度重新決定。
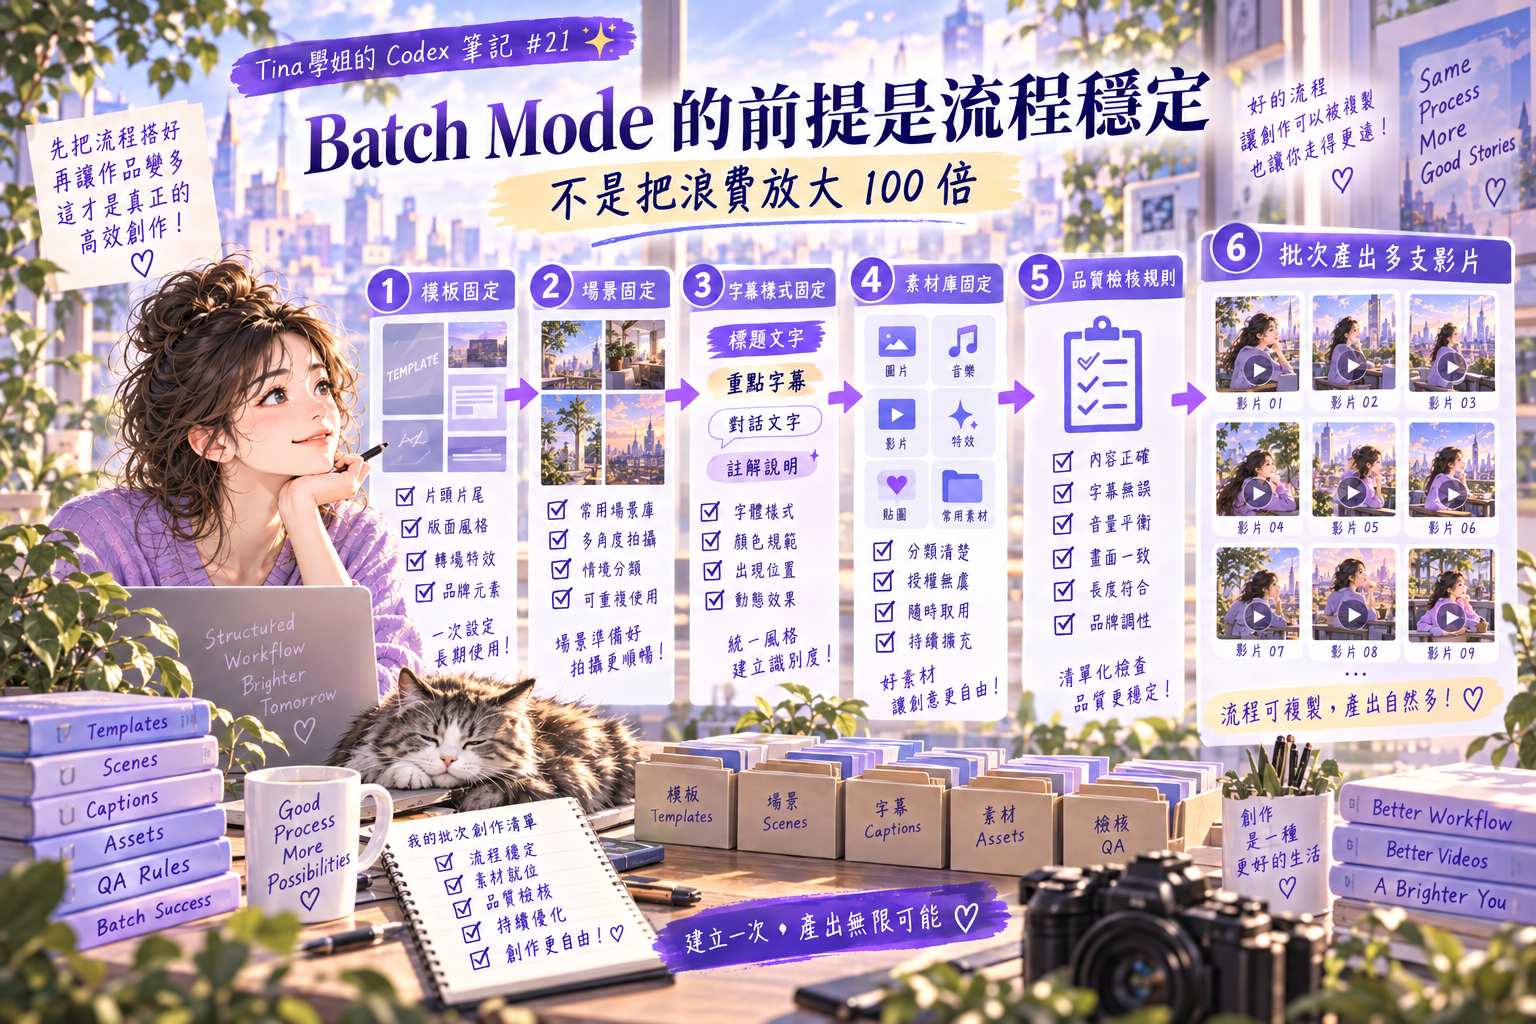
做到這裡,我開始理解 Batch Mode 要成立的前提
如果一支影片都還是:每次人工說明、每次重新規劃、每次完整重做,那一次做 100 支,基本上只是:把浪費放大 100 倍。
真正可以進 Batch Mode 之前,反而要先做到:模板穩定、資料夾穩定、規則穩定、字幕穩定、Scene 可以獨立、錯誤可以局部修、素材可以重用,只有這些基礎做好,Batch 才真的有意義。
所以「一天做 100 支」真正要問的,可能不是速度
而是:100 支都需要重新思考嗎?100 支都要重新生圖嗎?100 支都要完整 Render 嗎?100 支如果有 20 支出錯,要全部重跑嗎?
這些問題,比:「一台電腦一天跑不跑得出 100 支?」更重要。
Tina學姐這次最大的體會:額度不夠,反而逼我把 Workflow 做得更成熟
這件事情我自己覺得滿有意思,如果 Codex 永遠無限量。
我可能很容易:不好看?重做!不滿意?再做!字幕錯?整支再跑!反正沒有成本。
可是當額度開始有感之後,我反而開始真正思考:這一層需要重做嗎?可以保留什麼?能不能只修 Scene 2?這個結果能不能 Cache?這個規則能不能寫進 Skill?
這時候我的工作方式,才真正從:「一直叫 AI 做東西」
慢慢變成:「設計一套可以維護的 AI 系統。」
寫在最後:真正省的不是額度,而是整個製作成本
表面上這一篇是在談:Codex 額度,但做到最後,我覺得省下來的其實不只有額度。
還有:我的時間、等待時間、生圖次數、數字人次數、Render 次數、重新 QA 的時間、甚至重新判斷的腦力。
當一支影片可以做到:字幕是字幕、Scene 是 Scene、圖片是圖片、Presenter 是 Presenter、Motion 是 Motion,每一層都能獨立替換。
這時我才真的覺得:這不再只是一支 AI 影片,而是一套可以被維護、被更新、被大量複製的影片系統。
而這件事情,可能比單純多買一些額度,更重要。