

上一篇第 18 篇,我整理了自己從 PPT Animation 走到 Illustrated Storytelling 的過程。
我開始不再只問:「標題要從哪裡飛進來?」而是改問:「這一段內容,畫面到底應該發生什麼事?」也就是先有 Visual Event,再有 Story Frame。
做到這裡之後,我原本以為影片應該會好看很多了。
結果新的問題馬上出現:Story Frame 很漂亮,可是它還是一張圖。
人物、桌子、窗戶、背景、手機、文件、咖啡杯、光線,全部已經被 AI 畫在同一張 PNG 裡。
這時候 HyperFrames 能做什麼?整張放大、整張縮小、往左移、往右移、Fade In、Fade Out。
做久了我才發現:插畫有故事,不代表這張插畫本身已經適合做 Motion Graphics。
這就是我開始研究 Layered Motion Graphics 的原因。
先講結論:一張 AI 插畫最大的問題,就是「所有東西黏在一起」
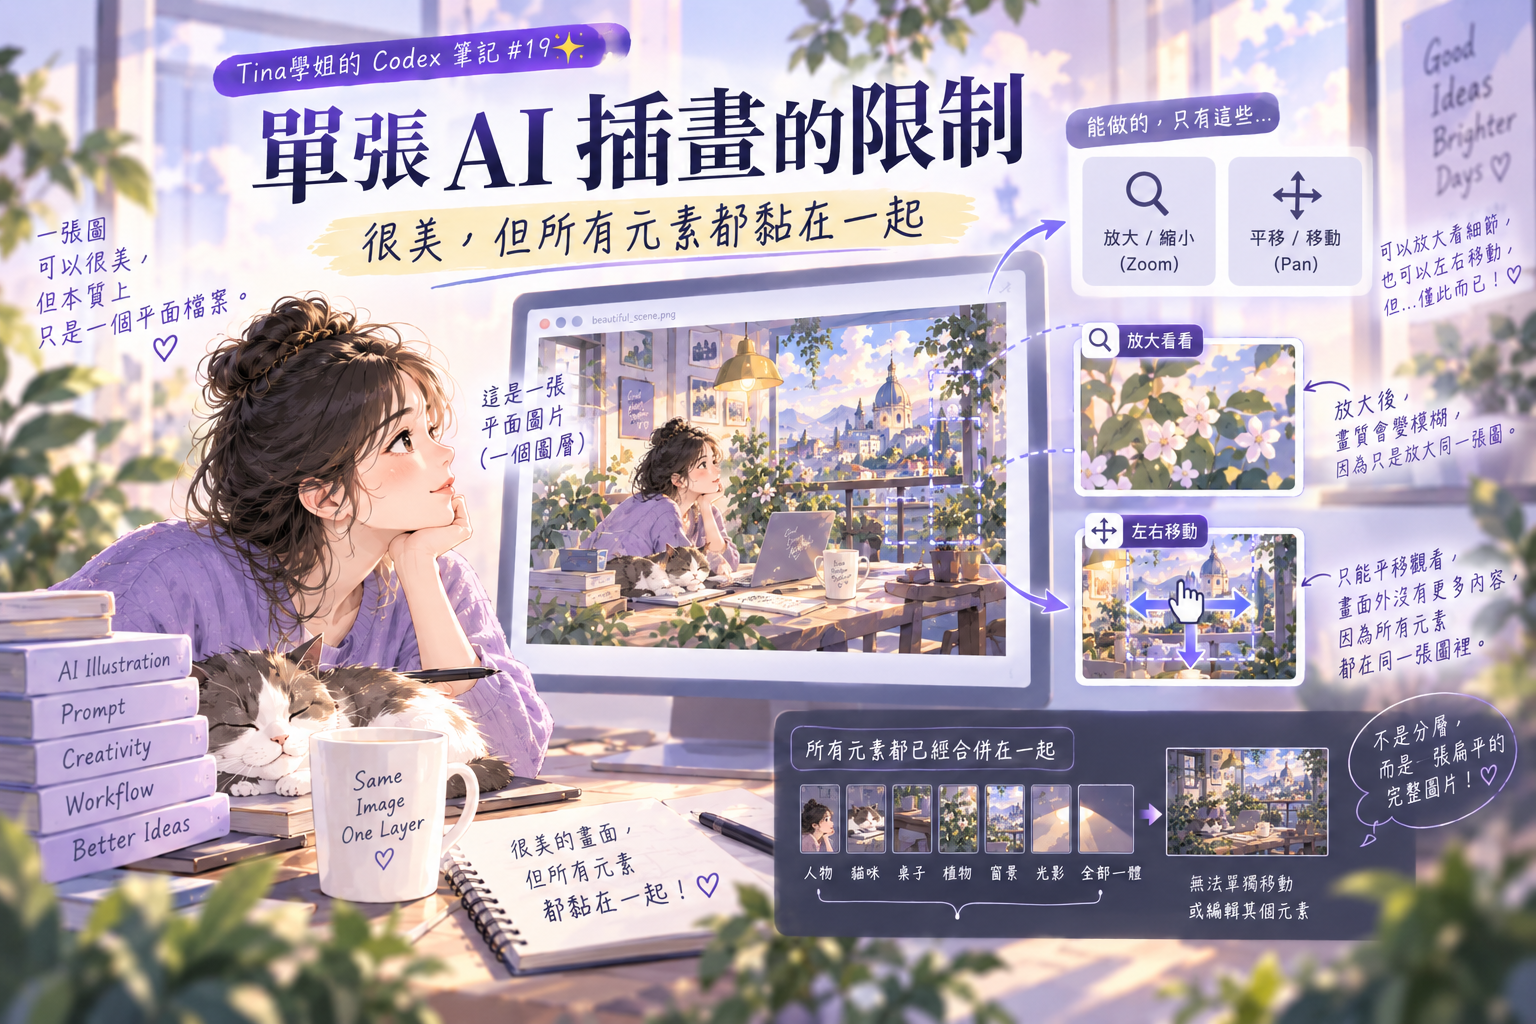
假設我有一張很好看的 AI 圖。
畫面裡有一位女生坐在辦公桌前,桌上有筆電、手機、文件、咖啡,後面是窗戶和城市景。
如果這整張就是:scene-01.png
那 HyperFrames 看到的其實不是:人物、桌子、手機、城市、窗戶。
而只是:一個 1920×1080 或 1080×1920 的矩形圖片。
也就是說,我如果把人物放大,背景也一起放大;手機往上飛,桌子也跟著飛;想讓窗外城市慢慢推近,也做不到。因為它們根本沒有被分開。
這就是「漂亮靜態圖」和「可動畫素材」最大的差別
| 漂亮 AI 插畫 | Layered Motion 素材 |
|---|---|
| 重點是整張圖好不好看 | 重點是元素能不能獨立控制 |
| 人物、背景、物件已經合成 | 人物、背景、物件分成不同 Layer |
| 適合當 Story Frame | 適合做時間軸動畫 |
| 主要靠 Zoom/Pan | 可以做 Parallax、遮罩、獨立位移 |
| 畫面是一張平面 | 畫面開始有前後景與深度 |
所以我現在會把流程拆成兩件事。
-
- 第一件事:先做漂亮的 Story Frame。
- 第二件事:再把 Story Frame 拆成能動的 Layer。
那一個 Scene 到底要拆幾層?
一開始我也會很貪心。
人物頭髮拆一層、眼睛一層、手一層、咖啡一層、筆一層,結果還沒做動畫,檔案已經多到自己都搞不清楚。
後來我覺得,知識短片其實沒有必要拆到動畫電影那麼細。
最實用的是先抓:「這個東西未來會不會需要和其他東西用不同速度、方向或時間移動?」
如果答案是會,就值得獨立一層。
我現在最基本會先想五大 Layer
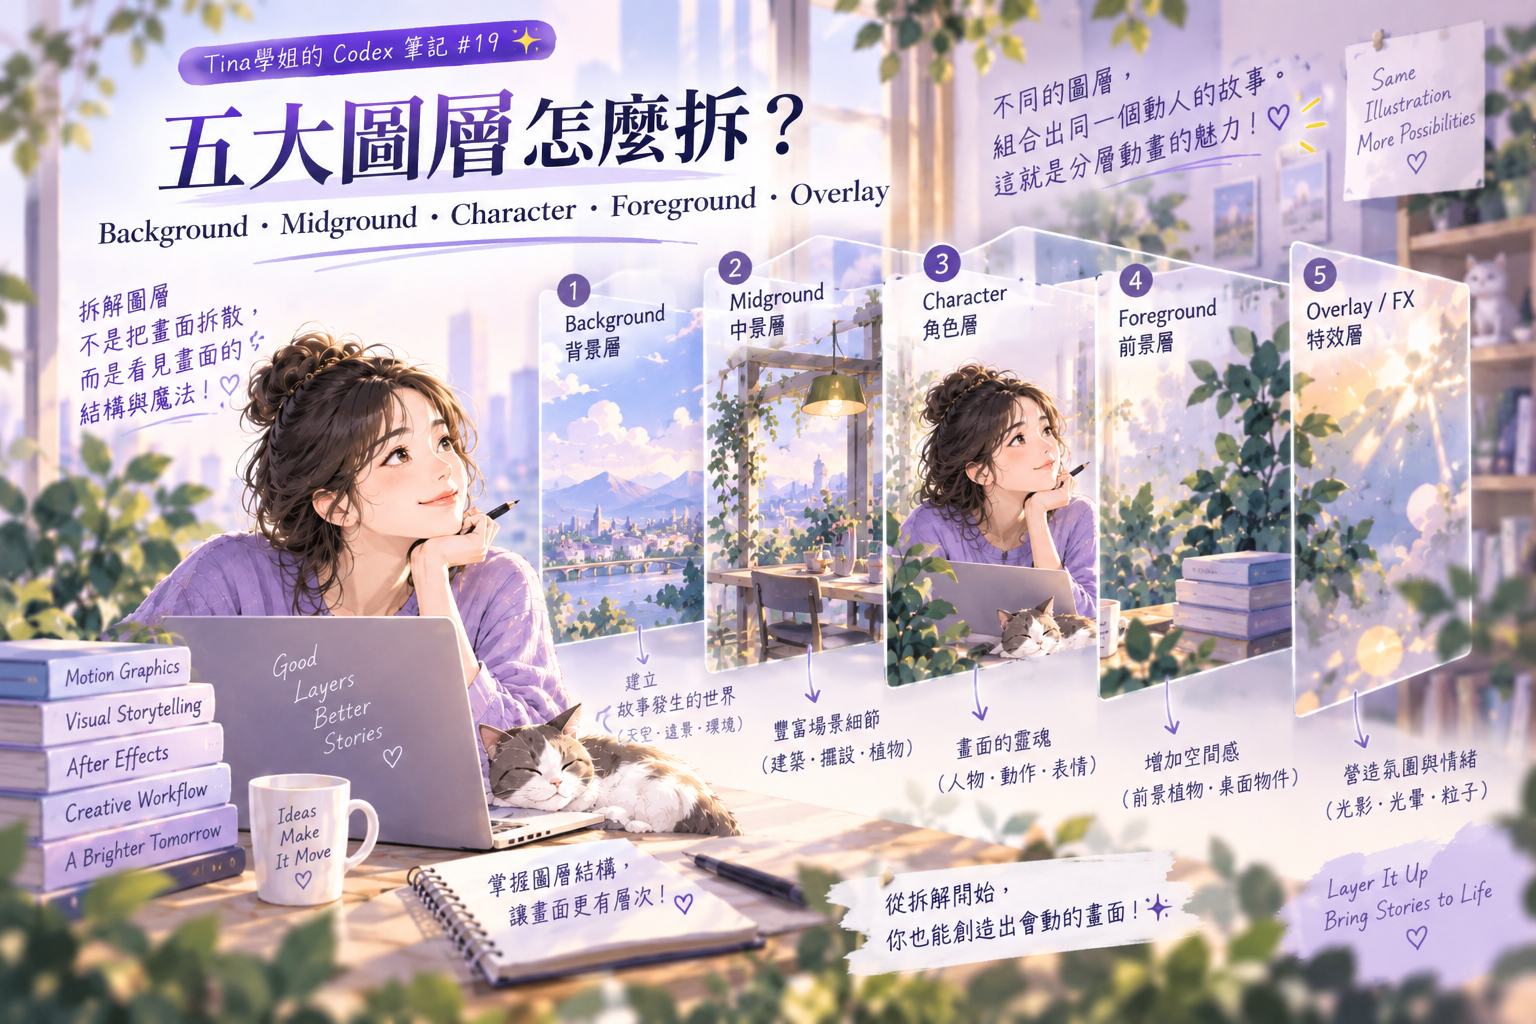
| Layer | 主要內容 |
|---|---|
| Background | 天空、牆壁、窗外、遠景、環境 |
| Midground | 桌子、家具、建築、主要空間物件 |
| Character | 人物、講師、角色 |
| Foreground | 咖啡杯、葉子、文件、靠近鏡頭的遮擋物 |
| Overlay / FX | 字幕、Key Phrase、通知、光影、粒子、箭頭 |
光是這五層,就已經可以讓原本一張完全平面的 AI 插畫,開始有很多變化。
例如咖啡店畫面,分層之後會發生什麼?
上一篇我提過:前景、中景、背景。
這個概念其實就是 Layered Motion Graphics 很重要的基礎。
假設咖啡店 Scene 拆成:
bg-city.png
bg-cafe.png
character.png
table.png
foreground-cup.png
foreground-plant.png
text-keyphrase.png
那動畫就可以變成:城市背景慢慢推近 2%、咖啡店內部推近 4%、人物推近 7%、前景咖啡杯移動 12%、Key Phrase 最後才浮出來。
所有元素都往同一個方向移,但速度不同。觀眾就會產生一種鏡頭正在穿過空間的感覺。
這就是最基本的 Parallax
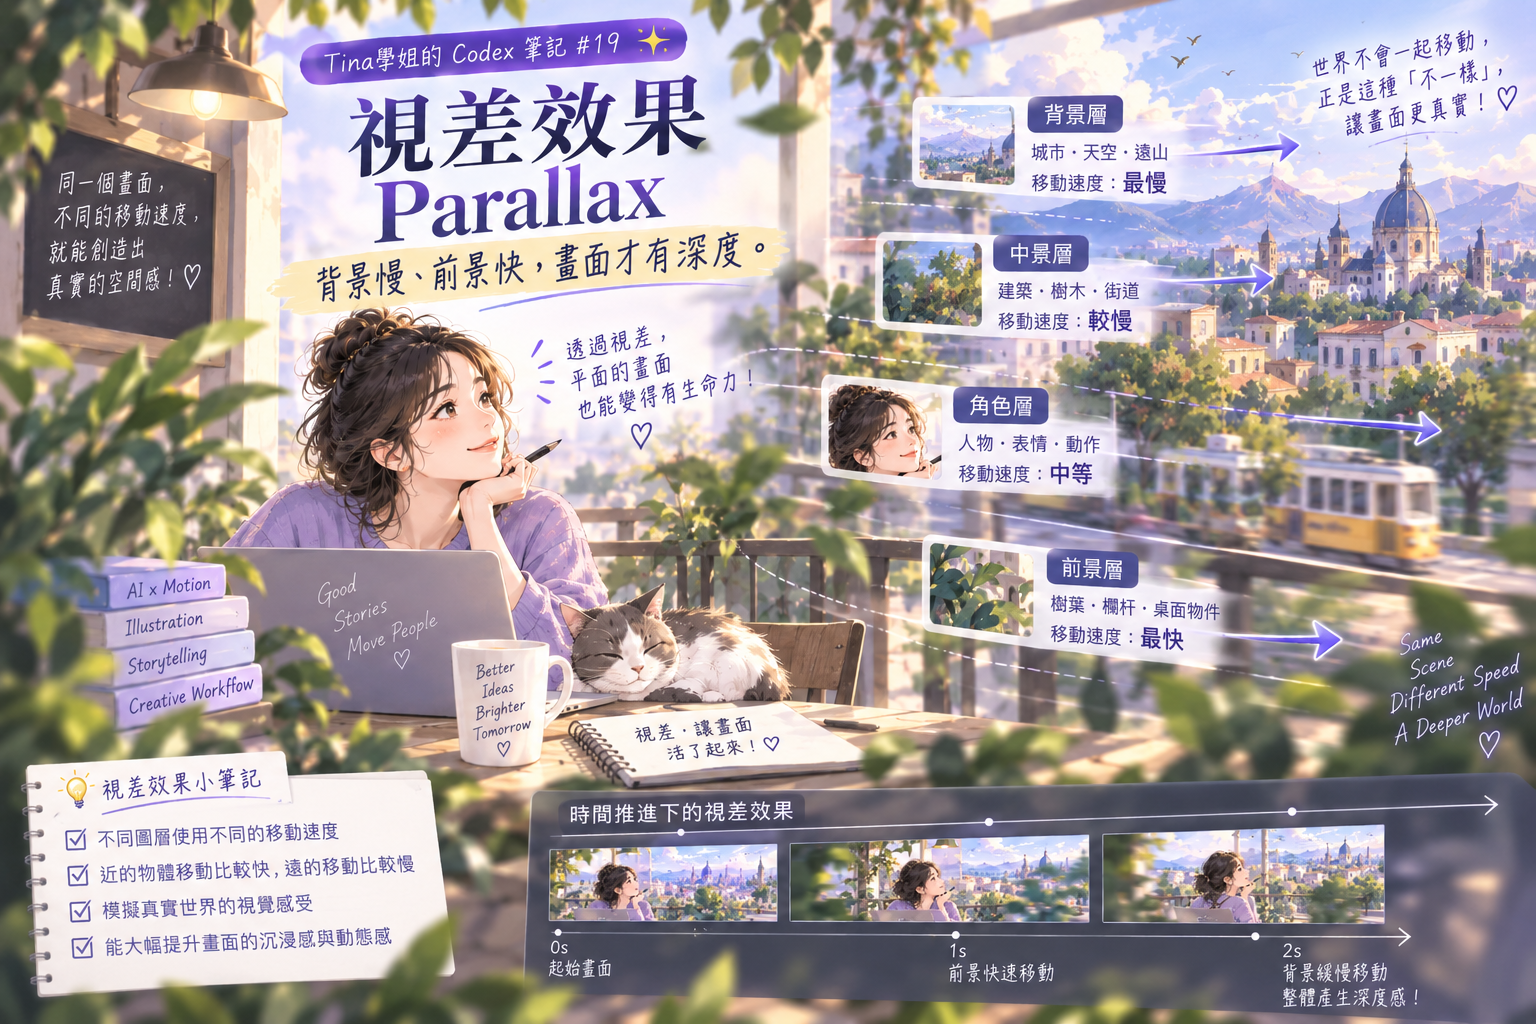
Parallax 中文通常會理解成:視差效果。
其實概念沒有那麼神秘。
坐車看窗外就很明顯,很遠的山移動得很慢,附近的電線桿一下子就從眼前飛過。
所以影片裡只要讓:背景慢、中景中等、前景快,畫面就會開始出現「深度」,而不是一張圖片整張滑過去。
為什麼這個效果對 AI 插畫特別重要?
因為 AI 插畫本來就很容易有:漂亮光線、漂亮構圖、漂亮景深。
但是它原本的景深只是:畫出來的。並不是真的有空間。
一旦拆成 Layer,就可以把「畫出來的深度」變成:時間中的深度。
也就是畫面真的會有前後移動。
第一種拆法:先從最重要的角色拆
如果這個 Scene 有人物,Character 通常會是我第一個想到的 Layer。
因為人物很常需要:稍微放大、往前移、左右位移、局部遮罩,或者讓背景在人物後面動。
所以最基本可以有:
background.png
character.png
foreground.png
光是三層,其實就已經可以做出比單圖 Zoom 好很多的效果。
第二種拆法:把會「發生事情」的物件獨立出來
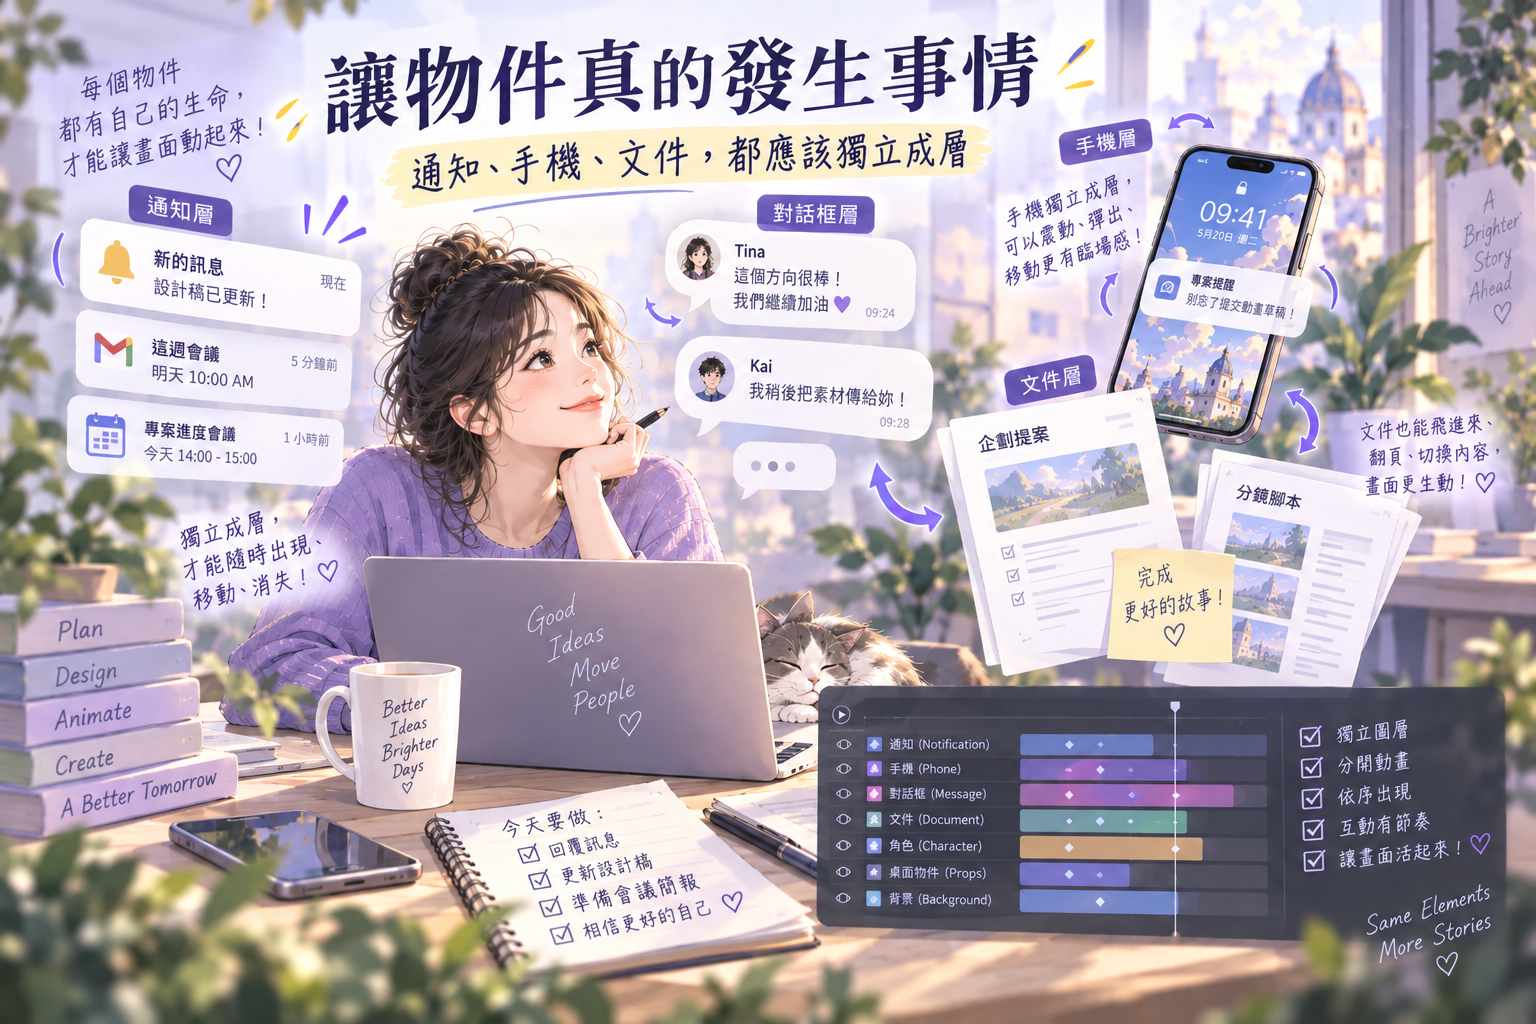
例如上一章那個忙碌辦公室的 Visual Event。
口播在講:訊息一直進來。
如果所有通知都已經畫在背景裡,那它們只能從一開始就存在。
但如果拆成:
notification-email.png
notification-chat.png
notification-calendar.png
notification-boss.png
那就可以:0.8 秒 Email 飛進來、1.2 秒團隊訊息跳出來、1.7 秒會議提醒出現、2.1 秒老闆訊息壓上去,這時「資訊過載」就不是寫在畫面上的一句話。
而是真的:在觀眾眼前發生。
這就是 Layer 和 Visual Event 開始真正接起來的地方
第 18 篇我一直強調:每個 Scene 要有 Visual Event。
到了第 19 篇就會發現:如果沒有 Layer,很多 Visual Event 根本演不出來。
因為「事情發生」代表:某個元素要在某一秒出現、消失、移動、被遮住、被放大、改變狀態,這都需要它可以獨立控制。
第三種拆法:文字一定不要直接畫死在 AI 圖裡
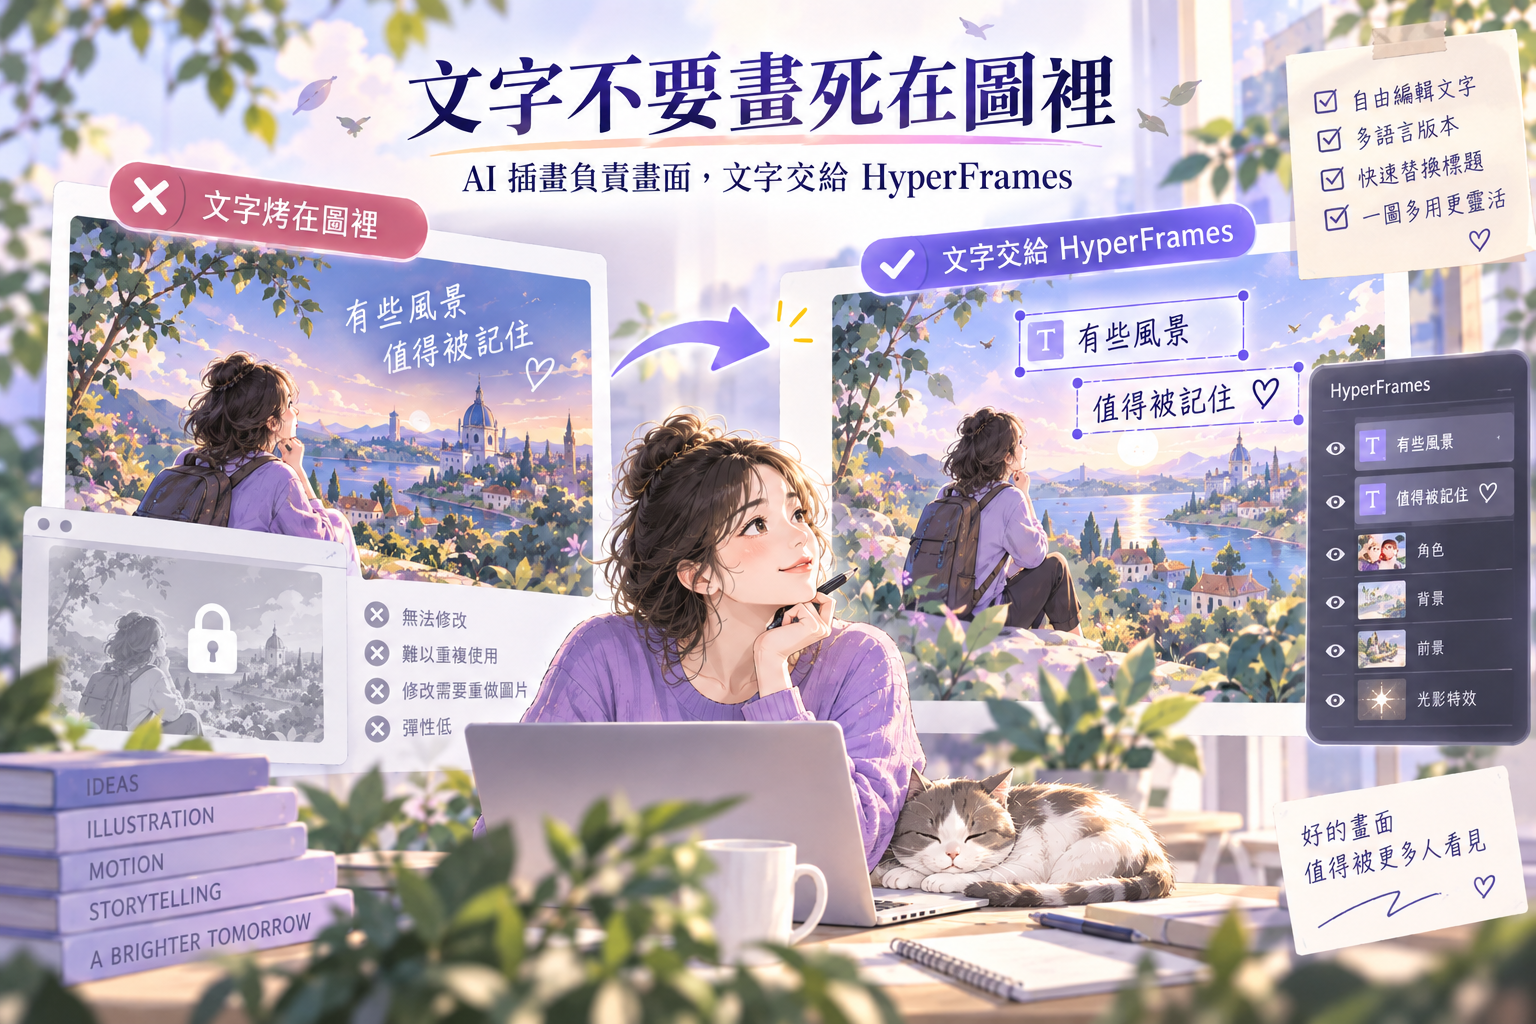
這點我現在會特別注意。
以前生成 AI 圖時,很容易直接要求:
畫面上寫:「資訊過載」、「被打斷」、「真正重要的事」,結果文字真的生成進圖片,但是這對 Motion Graphics 很不方便。
因為後面不能:換字、改位置、分段出現、做 Highlight、配字幕節奏。
所以現在我會更傾向:AI 插畫負責畫面,文字交給 HyperFrames。
也就是 Story Frame 和 Final Frame 不一定一模一樣
Story Frame 可以先拿來決定:人物在哪、物件在哪、背景怎麼構圖、視覺焦點在哪。
但真正要進 HyperFrames 的 Final Assets,可以把文字拿掉。
改成:
character.png
background.png
phone.png
documents.png
keyphrase.html
captions.json
這樣就更容易後續控制。
第四種拆法:前景元素其實非常有用
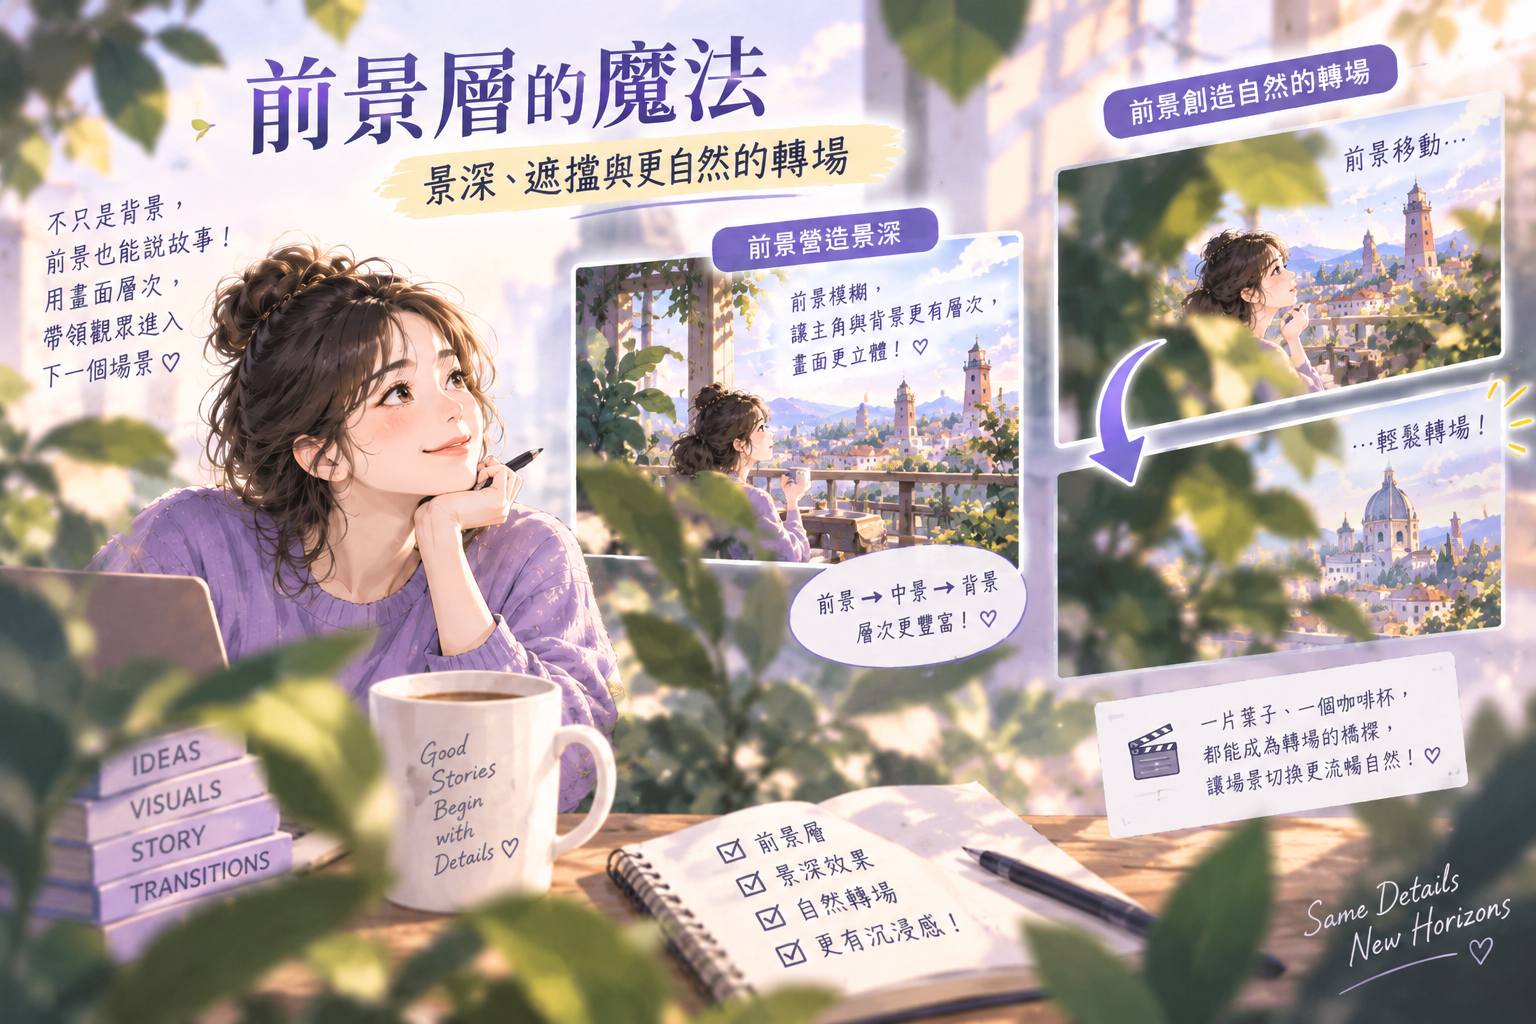
我以前很容易覺得:前景那片葉子、模糊咖啡杯、桌角,到底有什麼重要?
後來才發現,前景層其實是最便宜的「影片感製造器」之一。
因為只要前景比背景移動速度快,畫面就會立刻有深度。
例如:背景城市慢慢左移、人物只微微推近、前景葉子快速滑過一點點、哪怕角色自己沒有真的做動作,畫面也會比整張 PNG 平移自然很多。
Foreground 還可以拿來做遮擋轉場
例如一大片葉子從鏡頭前經過。
當它遮滿畫面時:Scene 01 換成 Scene 02,等葉子離開,觀眾已經到了下一個場景,或者咖啡杯從畫面前方放大經過,滿版的瞬間換 Scene。
這種轉場其實比:Fade Out、Fade In更自然。因為它看起來像鏡頭裡真的有東西經過。
第五種 Layer:光影和特效也可以獨立控制
例如陽光、光斑、粒子、陰影、Highlight,這些如果直接畫死在背景裡,就永遠不會改變。
但拆成 FX Layer 之後,可以:慢慢變亮、輕微漂移、閃一下,跟著重點文字出現,甚至用來幫觀眾視線聚焦。
我現在會把 Motion 分成三種等級
| Motion 類型 | 用途 |
|---|---|
| Ambient Motion | 很小的背景動態,例如光影、粒子、慢推鏡 |
| Focus Motion | 引導觀眾注意某個重點,例如 Highlight、放大、通知彈出 |
| Story Motion | 真正推進內容,例如文件被抽出、手機跳通知、角色離場 |
這三種如果全部混在一起,畫面會很亂。
所以每一秒最好還是先問:現在是哪一種 Motion 在工作?
不是所有 Layer 都一定要動
這個觀念也非常重要。
一看到「Layered Motion Graphics」,很容易想:既然都拆開了,那全部都給它動一下。
背景動、人物動、桌子動、字動、杯子動、光也動,結果又回到第 18 篇的問題:全部都在動,但不知道要看哪裡。
所以 Layer 的價值不是每個都要動。而是我終於可以選擇「誰現在不要動」。
例如一個 5 秒 Scene,我可能只安排三個動作
假設口播在講:「真正耗掉時間的,往往不是工作本身,而是不斷被打斷。」
我可能安排:
0.0–1.5 秒:
人物與辦公室維持穩定
背景非常輕微推近

1.5–3.5 秒:
Email、聊天、會議提醒依序彈入

3.5–5.0 秒:
其他元素略暗
「被打斷」Key Phrase 出現
就這樣,其實不需要 20 種動畫。因為真正的故事只有:原本在工作 → 干擾越來越多 → 最後看見核心問題。
Layered Motion Graphics 最大的價值,是可以「控制節奏」
單張圖很容易變成:畫面從第一秒到第五秒都已經完整存在,觀眾第一秒其實就看完了,剩下四秒只是聽聲音。
但是拆 Layer 後,可以把資訊安排在時間上。
第 1 秒只看到人物 → 第 2 秒多一個手機 → 第 3 秒出現通知 → 第 4 秒畫面開始壓迫 → 第 5 秒才揭露 Key Phrase。
這才會有:「下一秒還會發生什麼?」的感覺。
那 AI 圖到底要怎麼生,才比較適合之後拆 Layer?
這也是非常實際的問題。
如果一開始生成的構圖就太複雜:頭髮跟背景纏在一起、人物抱著很多東西、手和文件重疊、背景一堆細碎植物,後面要去背會很痛苦。
所以如果我知道這張是:未來要拆 Layer 的 Story Frame。
我會更注意:
-
- 人物輪廓清楚
- 重要物件彼此不要過度重疊
- 背景不要太花
- 人物周圍保留一些空間
- 要動的物件盡量完整露出
- 不要讓重要文字直接生成在圖片裡
甚至可以一開始就直接分開生成
例如不要先生成一張完整辦公室。
可以分成:背景辦公室、人物透明 PNG、桌子、手機、文件、通知圖示,這樣雖然前面素材準備比較多,但是後面 Motion 的自由度非常高。
我現在會把它分成兩種素材策略
策略 A:先生成完整 Story Frame,再拆
優點是:整體構圖通常比較自然;角色、光線、背景容易一致。
缺點則是:拆 Layer 比較麻煩、有些被遮住的地方甚至根本沒有畫。
策略 B:先規劃 Layer,再分開生成素材
優點是:每個素材可以獨立動畫,非常適合 HyperFrames。
缺點是:後面要重新做構圖,而且不同素材之間可能風格不一致。
所以我目前反而覺得:Story Frame 先用來定構圖,再依照它重新準備動畫 Layer,可能是比較穩的做法。
有一個問題非常容易被忽略:被人物擋住的背景去哪了?
例如完整插畫裡:人物坐在桌前、人物背後有一扇窗,如果我直接把人物去背,人物拿掉後,原本人物遮住的那一塊窗戶其實是:空的。因為 AI 根本沒畫過。
所以後面想讓人物往右移時,就會露出一個洞。
這時就需要:背景修補、Inpainting,或者另外生成一張:完整無人物背景。
所以比較乾淨的素材包,可能會長這樣
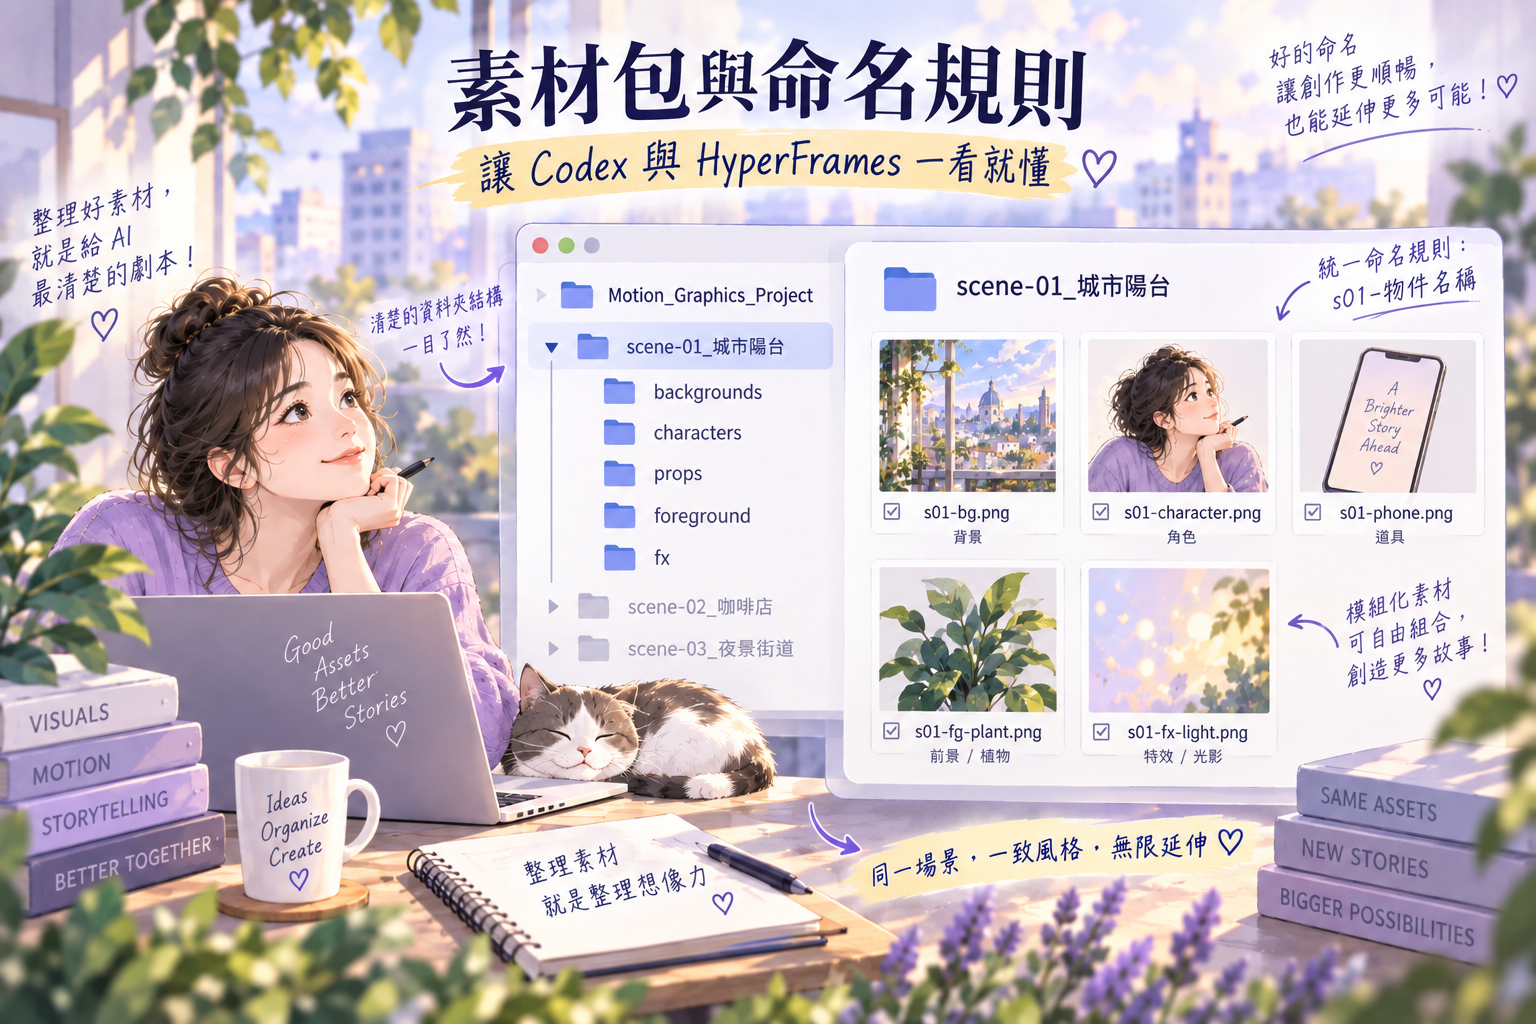
scene-01/
├── background-clean.png
├── character.png
├── desk.png
├── phone.png
├── documents.png
├── foreground-plant.png
├── fx-light.png
└── scene-notes.md
這樣 Codex 或 HyperFrames 後面才知道:每一個東西到底是什麼。
檔名也開始變得很重要
如果全部叫:
image1.png
image2.png
image3.png
final.png
final2.png
做到 30 支影片時,大概會瘋掉。
所以我現在反而會建議:
s01-bg.png
s01-character.png
s01-desk.png
s01-phone.png
s01-fg-plant.png
s01-fx-light.png
一看就知道:Scene 01。
背景、人物、前景、特效。
這也讓 Codex 比較容易自動讀取素材
因為如果檔名有規則,未來就可以讓程式知道:
-
- bg = Background。
- character = Character。
- fg = Foreground。
- fx = Effect。
這時 Layered Motion Graphics 就開始有機會真的變成:可批次執行的 Workflow。
Layer 本身也可以有自己的 Motion DNA
這是我覺得做到這裡很有意思的一點。
例如可以預先定義:
| Layer | 預設 Motion |
|---|---|
| Background | 慢速 Pan / Scale |
| Character | 小幅 Scale / Drift |
| Foreground | 較快位移,製造 Parallax |
| Key Phrase | 依節奏淡入/放大 |
| Notification | 快速 Pop In |
| FX Light | 緩慢閃爍/漂移 |
當這些規則固定之後,以後換一個 Scene,就不用每一次重新設計所有動畫。
但這裡又要非常小心:不要讓 Motion DNA 變成新的模板感
如果每支影片:背景永遠從右往左、人物永遠放大 5%、Key Phrase 永遠彈一下、通知永遠從右邊飛進來,做久之後,觀眾一樣會看膩。
所以比較好的方式是:有預設,但允許 Scene 根據故事改變。
就像前面做銷售頁 Variant 一樣,規則不是用來限制創意,是用來減少每次都從零開始。
Layered Motion Graphics 也不是 2.5D 越重越好
看到分層,很容易開始追求:大幅 Parallax、鏡頭衝進去、人物一直浮動、背景一直晃。
但知識影片真正重要的還是:讓人看懂。
如果動畫太強,觀眾反而會一直注意:「這張圖在動。」而不是內容。
所以我的方向會比較偏:Motion 要讓畫面活,而不是讓觀眾察覺「我在做 Motion」。
手機短片尤其要小心 Safe Zone
因為我們現在很多知識片是直式。
-
- 上面可能有:標題。
- 中間有:Story Scene。
- 左下還可能有:AI Presenter。
- 最底下又固定:字幕。
這時 Layer 動來動去,很容易突然:人物壓到字幕、Key Phrase 跑到平台 UI、前景把 Presenter 擋住。
所以每一個 Motion 其實都要尊重:Safe Area。
Layer 動畫最好不要只看起始位置,也要看整段路徑
例如一個通知從右邊飛進來,開始位置沒有擋人、結束位置也沒擋人,可是飛進來的途中,剛好穿過 AI Presenter 的臉,這還是很怪。
所以我現在會覺得 QA 不能只看:第一幀和最後一幀。還要看:動畫中間到底經過哪裡。
我現在的 Layered Motion Graphics QA,大概會看這幾件事情
-
- 人物去背邊緣是否乾淨
- 背景被人物遮住的位置是否補完整
- 不同 Layer 的光線是否一致
- Parallax 有沒有太誇張
- 前景是否不小心擋住重點
- 字幕與 Presenter 是否仍在 Safe Zone
- 文字是否獨立而不是畫死在圖裡
- 移動過程是否穿過不該經過的區域
- Scene 結束時是否能自然接下一幕
一張 AI 圖最大的限制,其實不是畫質
以前我可能會一直想:這張圖解析度夠不夠高?人物漂不漂亮?手有沒有畫錯?當然這些都重要。
但是做到影片之後,我開始覺得另一件事更重要:這張圖有沒有「可以被控制的結構」?
如果整張圖再漂亮,都只能整張一起動,它的影片彈性其實很低。但如果素材被拆成幾個乾淨 Layer,即使每一個元素單獨看沒有那麼華麗,最後組起來反而更有影片感。
這也是我從「AI 生圖」走到「AI 影片素材設計」的一個轉變
以前我的 Prompt 可能只會寫:幫我生成一張漂亮的辦公室插畫。
現在如果是影片,我開始會想:人物未來要不要去背?手機要不要獨立動?窗外要不要做 Parallax?前景要不要有遮擋?文字是不是另外做?
這已經不是:「我要一張圖。」而是:「我要一組可以組成影片的視覺資產。」
這時 image generation 也開始變成 Workflow 的一部分
例如未來 Codex 可以根據 Scene Spec,自動判斷:
這一幕需要:
1 × Background
1 × Character
2 × Interactive Objects
1 × Foreground
3 × Notification Overlays
再把需求交給生圖工具,產完之後依照命名規則放進對應資料夾。
HyperFrames 再自動抓取。這時整條流程就開始變成:
Script
↓
Visual Event
↓
Story Frame
↓
Layer Plan
↓
Asset Generation
↓
Layer Assembly
↓
Motion
↓
Preview
↓
QA
↓
Render
這其實比「一句話生一支影片」複雜很多
但是我現在反而覺得:複雜沒有關係,只要它是可以被重複的複雜。因為第一次建立很累。
可是當:Layer 命名固定、資料夾固定、Motion 規則固定、Safe Zone 固定、輸出流程固定,下一次就不是從零開始。
而且不是每支影片都一定要做完整 Layered Motion
這一點我也覺得很重要。
有些 15 秒影片,只要:一張插畫、兩個文字、一點 Zoom就夠了,如果每一支都拆十層,反而浪費時間。
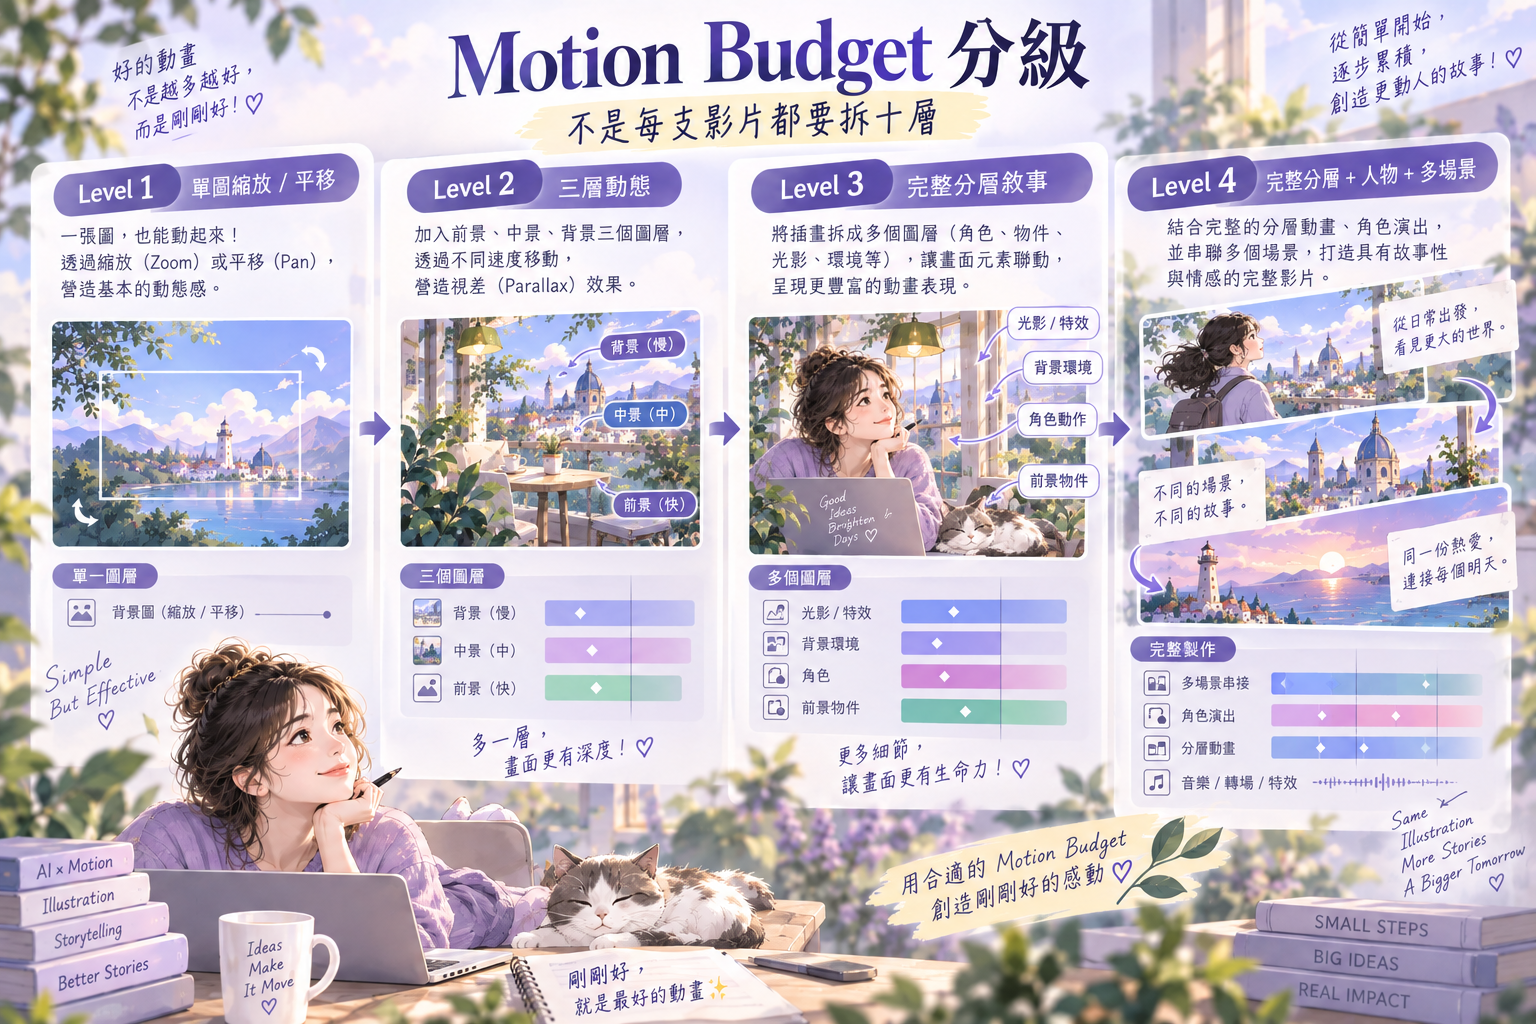
所以我現在會比較想做:Motion Budget。也就是先決定這支影片值得做到哪一級。
| 等級 | 做法 |
|---|---|
| Level 1 | 單圖+字幕+基本 Zoom/Pan |
| Level 2 | 背景+人物+文字三層 |
| Level 3 | 前中後景+互動物件+Visual Event |
| Level 4 | 完整 Layered Motion+Presenter+多 Scene 敘事 |
這樣比較符合真正大量生產影片的需求。
因為最終目標不是做一支神級影片,而是建立可以大量使用的品質標準
這件事我現在越來越有感。
如果一支影片花 8 小時做到超漂亮,但下一支又重新 8 小時,那其實不叫自動化。
我現在更在意的是:能不能把 70~80 分的品質穩定重複。然後真的重要的影片,再往 90 分修。
這樣才比較符合我想做的:10 支、30 支、甚至未來 Batch Mode。
Tina學姐這次最大的體會:不是把一張圖做動,而是把一個場景拆成可以動的結構
我覺得這就是 Layered Motion Graphics 最核心的一句話。
如果只有一張圖,我是在:移動圖片。
如果有 Layer,我開始可以:控制場景。
背景怎麼走、人物什麼時候出現、通知哪一秒進來、前景什麼時候遮住鏡頭、Key Phrase 哪一秒出現、光線怎麼變。
這時影片才真正從「一張會移動的 AI 圖」變成「一個會發生事情的場景。」
寫在最後:Story Frame 是起點,Layer 才是 Motion 的真正材料
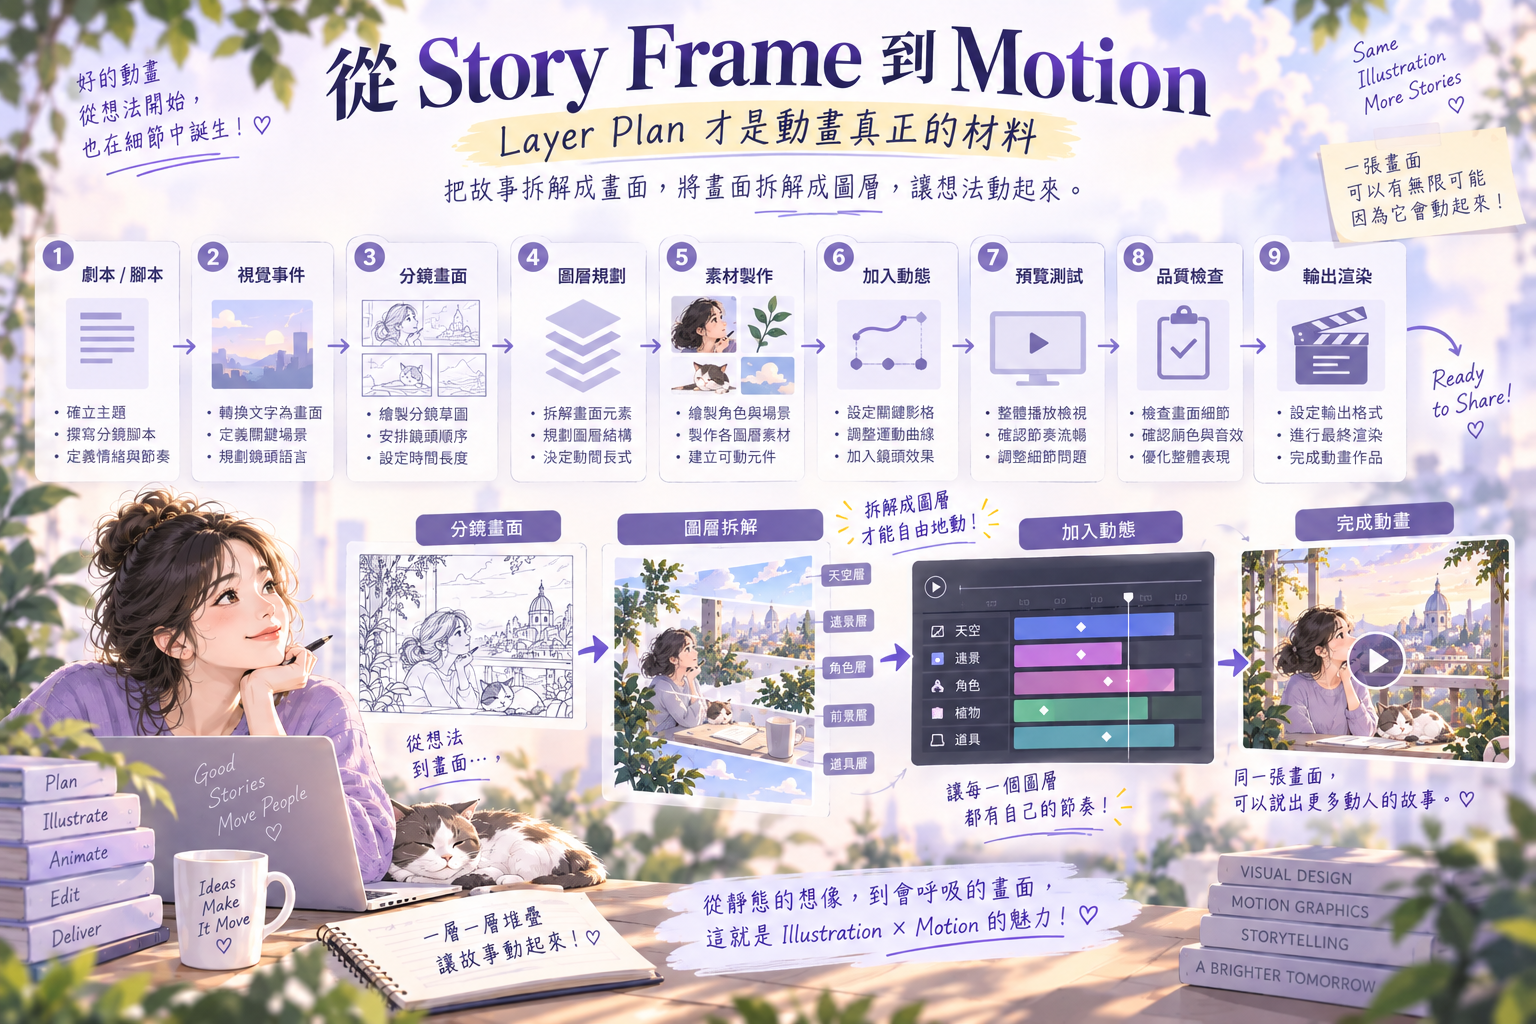
做到第 19 篇,我現在會把整套流程看得更清楚。
第 18 篇解決的是:畫面要說什麼故事?
第 19 篇解決的是:這個故事要拆成哪些東西,才有辦法真正動起來?
所以:
-
- Story Frame 負責構圖。
- Layer Plan 負責結構。
- HyperFrames 負責時間。
- Motion 負責讓故事在時間裡發生。
一張 AI 插畫可以讓人看到一個故事,但 Layered Motion Graphics 才能讓這個故事開始發生。